

Ang mga pamamaraan ng Deep Learning at Computer vision ay umuunlad sa lahat ng posibleng larangan. Dahil sa lumalaking kakayahan sa pag-compute, maraming organisasyon ang gumagamit nito upang malutas o mabawasan ang maraming pang-araw-araw na problema. Sa isang kamakailang panayam sa AVAR 2018 , ipinakita ng Quick Heal AI team ang isang paraan ng epektibong paggamit ng Deep Learning para sa pag-uuri ng malware. Narito ang detalyadong teknikal na blog para dito.
pagpapakilala
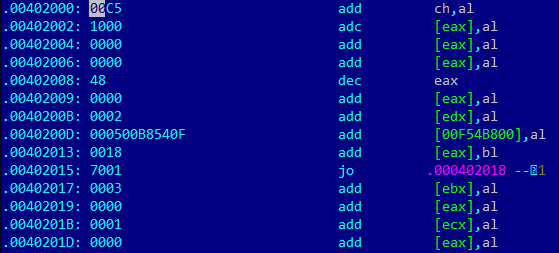
Sa ugat ng karamihan sa mga pag-atake ng malware ay nakasalalay ang mga PE file na siyang pangunahing sanhi ng pinsalang nagreresulta. Ang isang karaniwang pag-atake ay nagsisimula sa pag-download ng isang PE file sa pamamagitan ng email, website o iba pang karaniwang ginagamit na mekanismo. Ang mga tradisyonal na pamamaraan ng pag-detect ng mga naturang malisyosong PE file ay mula sa mga rule-based; signature-based static methods hanggang sa behavior-based dynamic methods tulad ng mga emulator, sandbox, atbp. Ngunit nabibigo sila sa karera ng pangkalahatang pag-detect ng mga advanced na malware. Ang larawan sa ibaba ay nagpapaliwanag ng isang halimbawa ng Crysis Ransomware ( Narito ang decryption tool para sa Crysis ). Ang halimbawang ito ay napaka-obfuscated kaya madali nitong nalalampasan ang mga mekanismo ng pag-detect na nakabatay sa rule o signature.
Upang labanan ang mga naturang mekanismo, ipinakilala namin ang pagtuklas batay sa Machine Learning. Kung saan, gumagamit kami ng maraming algorithm tulad ng SVM, Random Forest para sa generic na pagtuklas.
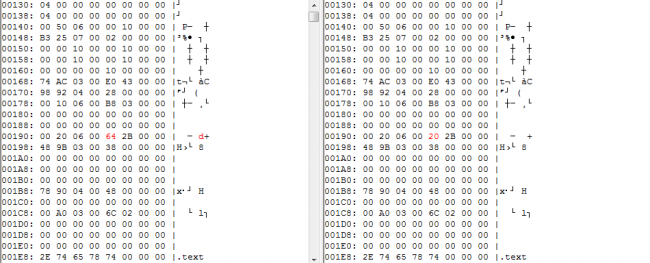
Ngunit ang ML ay nangangailangan ng pagkolekta ng sample at pagkuha ng feature bago ang pagsasanay. Ang feature engineering ay isang nakakapagod na gawain at nangangailangan ng kadalubhasaan at oras ng tao. At ito ay nagiging mas kumplikado araw-araw habang ang malware ay nakakahanap ng mga paraan upang malampasan ito. Ang mga pamamaraan tulad ng adversarial ML kung saan ang mga sample ng malware ay sinanay upang malampasan ang ML ay umuunlad nang napakabilis upang maiwasan ang mga modelo ng ML na nakabatay sa property. Tingnan natin ang isa pang halimbawa. Dito, ipinapakita ang header ng sample ng XPaj infector bago at pagkatapos ng impeksyon. Halos walang ginagawang pagbabago ang XPaj sa header ng orihinal na file habang dinadagdag. Ang modelo ng ML na sinanay lamang sa mga katangian ng header ng file ay hindi makaka-detect ng mga sample na ito.
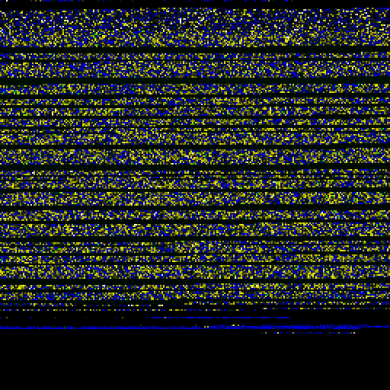
Malaki na ang narating ng Deep Learning kamakailan sa larangan ng image classification at computer vision . Maraming kwento ng tagumpay tungkol sa mga problema sa image classification sa Imagenet at Resnet. Kaya naisip namin ang paglalapat ng image classification upang matukoy ang mga malisyosong file.
Pag-convert ng mga PE file sa Mga Larawan
Ang unang hamon ay ang pagrepresenta ng mga PE file sa anyo ng mga imahe. Mula sa isang malaking hanay ng mga mapagkukunan, mayroon kaming napakaraming PE file sa aming data set. Nilagyan din namin ng label ang mga file na ito. Upang makabuo ng mga imahe, gumamit kami ng isang kilalang open source tool na tinatawag na PortEX . Ang tool na ito ay pangunahing bumubuo ng tatlong uri ng mga imahe tulad ng ipinapakita sa mga diagram sa ibaba.
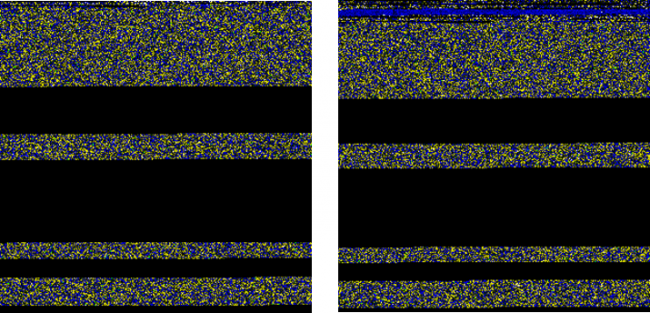
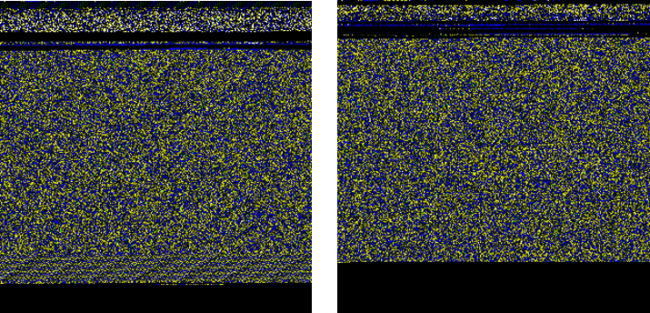
Una sa mga ito (Fig3) ay isang byte-plot na imahe, kung saan ang bawat byte o isang pangkat ng mga byte ay kumakatawan sa iba't ibang kulay na pixel tulad ng ipinapakita sa figure. At pagkatapos ay ang mga zero ay may palaman sa dulo upang panatilihing pare-pareho ang laki ng imahe. Sa byte-plot na larawang ito, ang mga zero ay itim at FF sa pamamagitan ng puting mga pixel ng kulay. Ang mga nakikitang ASCII na character ay mga asul na kulay na pix. At iba pa.
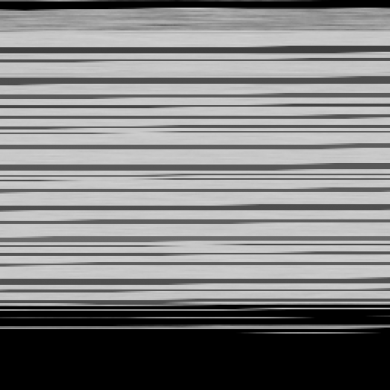
Sa pangalawang uri ng mga imahe, ang isang sukat ng solong kulay na pixel ay kumakatawan sa iba't ibang mga byte. Dito (fig 4) ang mga byte ay kinakatawan ng mga grayscale na pixel na 0x00 na itim at 0xFF puti.
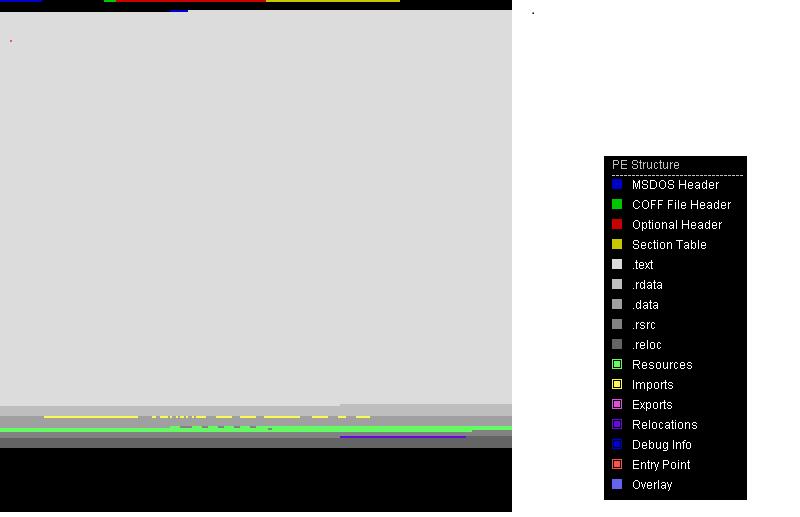
Sa huling uri (Larawan 5), kinakatawan ng mga imahe ng istruktura ng PE ang bawat istraktura ng isang file ng PE sa iba't ibang kulay na mga pixel. Tulad ng sa halimbawa, ang berde ay kumakatawan sa mga mapagkukunan, dilaw na pag-import, at ang sky blue na mga pixel ay kumakatawan sa nakadugtong na data. Matapos ilarawan ang mga PE file sa mga imahe, maaari nating ituro ang mga pagkakatulad ng dalawang magkaibang mga file sa pamamagitan lamang ng pagtingin sa mga ito. Nasa ibaba ang dalawang halimbawa ng naturang mga file.
Ipinapakita ng Figure 6 at 7 ang pagkakatulad ng dalawang magkaibang sample ng Wannacry at Cerber ransomware ayon sa pagkakabanggit.
Pangkalahatang-ideya ng Malalim na Pag-aaral
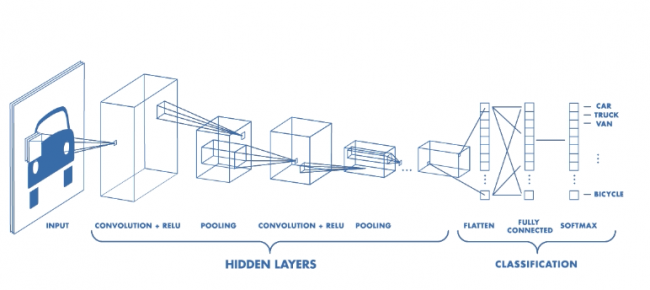
Dahil sa malaking dami ng datos na na-convert mula sa mga malinis at malware file, inilalapat na namin ngayon ang mga Deep Learning algorithm sa mga sample na ito. Ang Deep Learning (DL) o Deep Neural Network (DNN) ay isang espesyal na klase ng Machine Learning (ML). Ang Artificial Neural Networks (ANN) ay mga bloke ng pagbuo ng mga DNN. Ang mga ANN ay kumukuha ng inspirasyon mula sa mga biological nervous system. Ang mga problema sa pag-uuri ng imahe ay gumagamit ng isang espesyal na klase ng mga DNN. Ang mga ito ay Convolutional Neural Networks (CNN) . Ang mga CNN ay klase ng simpleng feed-forward neural network kung saan ang mga output ay ipinapasa sa mga susunod na layer nang hindi bumubuo ng mga cycle tulad ng sa kaso ng mga recurrent neural network. Mayroon silang mga non-linear activation function upang mabawasan ang linearity mula sa mga sinanay na feature. Mayroong apat na uri ng layer sa CNN at ang mga ito ay
- Convolution Layer
- Pooling Layer
- Pagpapatag na Layer
- Ganap na konektado Layer
Gumagamit ang Convolution layer ng maraming feature detector na kilala rin bilang mga filter o convolution kernels. Ang mga filter na ito ay dumudulas sa isang input na imahe upang bumuo ng mga tampok na mapa. Ang bawat feature detector ay bumubuo ng ibang feature map na tumutugma sa feature na sinusubukan nitong matutunan. Ang mga Feature Detector ay maliliit na matrice sa pangkalahatan na 3X3 na dimensyon.
Pagkatapos ay matatanggap ng pooling layer ang mga nabuong feature na mapa na ito. Ang layer na ito ay may pananagutan para sa pagsasama-sama lamang ng mga tampok na mahalaga at nag-iiwan ng mga hindi gustong feature kaya binabawasan ang sobrang pag-aayos at pagpapabuti ng oras ng pagsasanay. Ang pooling ay maaaring max pooling, mean pooling, average pooling atbp.
Ang flattening layer ay karaniwang ginagawang iisang column vector ang mga pinagsama-samang feature na mapa. Ang vector na ito ay ipinapasa sa isang ganap na konektadong layer ng isang ANN. Ipinapakita ng Figure 8 ang lahat ng mga layer ng isang simpleng CNN.
Mga Eksperimento at Resulta
Nang mapagdesisyunan na namin ang algorithm at mga sample, ang proseso ng pagsasanay ay katulad ng lahat ng mga pamamaraan ng Machine Learning gaya ng nabanggit namin sa aming blog tungkol sa machine learning . Ang isa pang kapaki-pakinabang na sangay ng DL ay ang Transfer Learning. Sa Transfer Learning, ang isang gawain sa pagsasanay ay gumagamit ng mga timbang ng ibang modelo na sinanay sa iba't ibang datos ng pagsasanay bilang mga paunang timbang para sa proseso ng pagsasanay. Ang mga modelo tulad ng VGG16 ay may mahusay na katumpakan sa hamon ng Imagenet. Maaari naming gamitin ang mga ito bilang panimulang punto ng aming pagsasanay. Sa Talahanayan 1, ipinakita namin ang ilan sa mga eksperimento na aming isinagawa gamit ang Transfer Learning.
| modelo | Detalye ng Modelo | Ratio ng pagtuklas | Ratio ng FP | |||
| Dataset | Arkitektura | Wala sa Epochs | ||||
| Linisin | malware | |||||
| 1 | 100k | 20k na Pantubos | VGG16 | 100 | 90.45 | 0.46 |
| 2 | 100k | 20k na Pantubos | VGG16 huling ilang layer na Trainable | 100 | 91.27 | 0.21 |
| 3 | 100k | 50k | VGG16 | 20 | 89.67 | 0.38 |
| 4 | 200K | 100k | VGG16 na may mga layer na Trainable | 20 | 91.04 | 0.19 |
(Tab 1: Ilipat ang Mga Eksperimento sa Pagkatuto)
Nakakuha kami ng magandang detection ratio ngunit ang False Positive ay isa sa mga alalahanin. Habang pinalaki namin ang laki ng set ng pagsasanay, mas lalong bumuti ang mga resulta. Sa pangalawang eksperimento, nagdisenyo kami ng mga multilayer na modelo ng CNN mula sa simula. Nakakuha kami ng magagandang resulta sa isang malaking set ng data kaysa sa ransom data. Para sa ransom data, mayroon kaming limitadong bilang ng mga sample para sa pagsasanay (Talahanayan 2).
| modelo | Detalye ng Modelo | Ratio ng pagtuklas | Ratio ng FP | |||
| Dataset | Arkitektura | Wala sa Epochs | ||||
| Linisin | malware | |||||
| 1 | 100k | 20k na Pantubos | 8 Layer na Modelo ng CNN | 20 | 89.36 | 0.61 |
| 2 | 100k | 50k | 8 Layer na Modelo ng CNN | 20 | 91.27 | 0.84 |
| 3 | 200K | 100k | 8 Layer na Modelo ng CNN | 20 | 92.67 | 0.16 |
(Tab. 2: Mga Eksperimento sa Deep Learning)
Konklusyon
Habang nakakakuha kami ng mahusay na ratio ng pagtuklas gamit ang modelo ng pag-uuri ng imahe, ang Deep learning ay magiging isang magandang karagdagan sa aming arsenal para sa pag-detect ng mga advanced na banta. Ngunit dahil may mga maling pagtuklas din. Samakatuwid, hindi namin ito magagamit bilang isang stand-alone na mekanismo. Sa halip, pinagsasama-sama namin ang mga kapangyarihan ng Machine learning, Deep Learning sa patuloy na lumalagong kapangyarihan ng Cloud upang makakuha ng mahusay na tagumpay sa pag-detect at babawasan nang malaki ang false.



