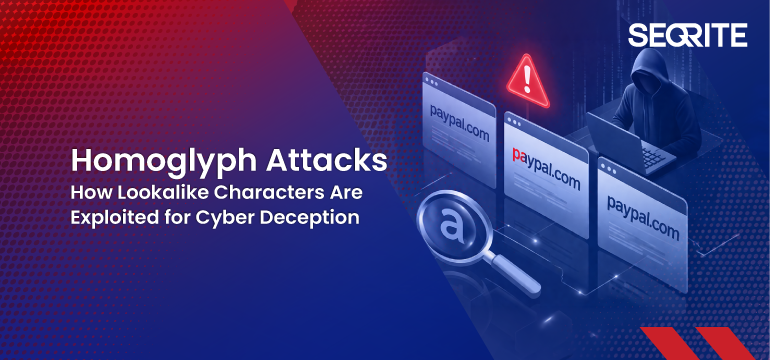
การโจมตีด้วยตัวอักษรที่คล้ายคลึงกัน: การใช้ตัวอักษรที่คล้ายคลึงกันเพื่อการหลอกลวงทางไซเบอร์
สารบัญ :
- บทนำ
- การโจมตีด้วยตัวอักษรเหมือนกันคืออะไร?
- โฮโมกลิฟเชิงปฏิบัติที่สับสนได้
- ตารางเปรียบเทียบคำพ้องรูปเชิงปฏิบัติ
- เหตุใดการโจมตีด้วยภาพเหมือนจึงได้ผล
- กรณีการใช้งานโฮโมกลิฟทั่วไปและช่องทางการโจมตี
- ตัวอย่างในโลกแห่งความเป็นจริงและรูปแบบการรณรงค์หาเสียง
- เจาะลึกทางเทคนิค — Unicode, IDN และ Punycode
- ยูนิโค้ดและสคริปต์
- IDN และ Punycode
- ตัวอักษรผสมและสับสน
- ขั้นตอนการโจมตี — ทีละขั้นตอน
- เหตุใดการตรวจจับจึงอาจล้มเหลว — ข้อผิดพลาดทางเทคนิคที่ซ่อนเร้น
- การทำแผนที่ MITER ATT&CK (ระดับสูง)
- มาตรการป้องกันและข้อเสนอแนะในการปฏิบัติงาน
- นโยบายและธรรมาภิบาล
- การควบคุมทางเทคนิค
- แนวทางการปฏิบัติงาน
- รายการตรวจสอบแนวทางปฏิบัติที่ดีที่สุด
- เทรนด์ใหม่ที่น่าจับตามอง
- สรุป
บทนำ
คุณเหลือบมอง URL เห็นชื่อแบรนด์ที่คุ้นเคย แล้วคลิกเข้าไป — เพียงเพื่อมอบข้อมูลส่วนตัวของคุณให้แก่ผู้โจมตี ความผิดพลาดเล็กๆ น้อยๆ ทางด้านภาพ (เช่น ตัว “o” ที่จริงๆ แล้วเป็นตัว “omicron” ของภาษากรีก หรือตัว “l” ตัวเล็กถูกแทนที่ด้วยตัว “i” ตัวใหญ่) คือสิ่งที่การโจมตีแบบโฮโมกลิฟใช้ประโยชน์ โฮโมกลิฟคือตัวอักษรที่ดูคล้ายกันจากชุดตัวอักษรที่แตกต่างกัน (เช่น ละติน ซิริลลิก กรีก รูปแบบเต็มความกว้าง ฯลฯ) เมื่อผู้โจมตีสลับตัวอักษรในโดเมน ชื่อไฟล์ ชื่อที่แสดงในข้อความ หรือโค้ด มนุษย์ — และระบบป้องกันอัตโนมัติบ่อยครั้ง — ก็จะถูกหลอก
การโจมตีด้วยตัวอักษรที่เหมือนกัน (Homoglyph attacks) เป็นเทคนิคการหลอกลวงที่มีต้นทุนต่ำแต่มีผลกระทบสูง มีการนำไปใช้ในการฟิชชิ่ง การปลอมแปลงแบรนด์ การแพร่กระจายมัลแวร์ การสร้างความสับสนในห่วงโซ่อุปทาน และการหลีกเลี่ยงกฎการตรวจจับแบบง่ายๆ บล็อกนี้จะอธิบายกลไกทางเทคนิค (Unicode, IDNs, Punycode) วิธีที่ผู้โจมตีนำตัวอักษรที่เหมือนกันไปใช้ การตรวจจับและการค้นหาแนวทางปฏิบัติ รูปแบบการใช้งานในโลกแห่งความเป็นจริง การแมป MITRE และการป้องกันเชิงปฏิบัติ รวมถึงวิธีการป้องกันแบบหลายชั้น เช่น Quick Heal / Seqrite ช่วย
การโจมตีด้วยโฮโมกลิฟคืออะไร?
โฮโมกลิฟ คือ ตัวอักษรที่มีลักษณะเหมือนกับตัวอักษรอื่น ตัวอย่างเช่น:
- ตัวอักษรละติน a (U+0061) เทียบกับ ตัวอักษรซีริลลิก а (U+0430)
- ละติน o (U+006F) เทียบกับ กรีก ο (omicron, U+03BF)
- ตัวอักษรละติน I (ตัวพิมพ์ใหญ่ i, U+0049) เทียบกับ ตัวอักษร l ตัวเล็ก (ell, U+006C) เทียบกับ ตัวอักษรซีริลลิก І (U+0406)
การโจมตีแบบโฮโมกลิฟ (Homoglyph attack) คือการแทนที่อักขระหนึ่งตัวหรือมากกว่าในตัวระบุ (โดเมน ชื่อไฟล์ ชื่อที่แสดงในอีเมล) ด้วยอักขระที่ดูสับสนเพื่อปลอมแปลงเป็นแหล่งข้อมูลที่เชื่อถือได้ เมื่อใช้ในชื่อโดเมนแบบสากล (Internationalized Domain Names หรือ IDNs) โดเมนเหล่านี้จะถูกแสดงในรูปแบบ ASCII โดยใช้ Punycode (คำนำหน้า xn--) แต่โดยทั่วไปแล้วจะแสดงผลในเบราว์เซอร์โดยใช้อักขระ Unicode ดั้งเดิม ทำให้ผู้ใช้เห็น URL ที่ดูเหมือนของจริง
ตัวอย่าง Punycode สั้นๆ (เชิงแนวคิด ไม่ระบุชื่อ):
โดเมนที่แสดง: google-example[.]com (ใช้อักษรกรีก omicron แทนอักษรละติน 'o')
รหัส Punycode (ASCII): xn--gogle-example-abc[.]com
โฮโมกลิฟเชิงปฏิบัติที่สับสนได้
การโจมตีด้วยตัวอักษรที่คล้ายคลึงกัน (Homoglyph attacks) ใช้ประโยชน์จากตัวอักษรที่ดูคล้ายกันจากภาษาต่าง ๆ เช่น ละติน ซิริลลิก และกรีก ตัวอักษรที่ดูคล้ายกันเหล่านี้สามารถหลอกลวงผู้ใช้ ปลอมแปลงโดเมนที่น่าเชื่อถือ และแม้กระทั่งหลีกเลี่ยงตัวกรองอัตโนมัติบางตัวได้
ด้านล่างนี้คือข้อมูลอ้างอิงโดยย่อที่แสดงคู่ตัวอักษรที่เหมือนกันซึ่งมักถูกนำไปใช้ในทางที่ผิดในแคมเปญฟิชชิ่งและการปลอมแปลงตัวตน
ตารางเปรียบเทียบคำพ้องรูปเชิงปฏิบัติ
| ของ Visual | ตัวละครที่ชอบธรรม | คนหน้าเหมือน | ต้นฉบับ | การใช้งานทั่วไปในการโจมตี |
| a | a (U+0061) | а (U+0430) | ซิริลลิก | “paypal”, “facebook” |
| e | e (U+0065) | е (U+0435) | ซิริลลิก | “ไมโครซอฟต์”, “เทสลา” |
| o | o (U+006F) | о (U+03BF), о (U+043E) | กรีก / ซิริลลิก | “กูเกิล”, “ไมโครซอฟต์” |
| i | i (U+0069) | ı (U+0131), І (U+0406) | ภาษาตุรกี / อักษรซีริลลิก | “อินสตาแกรม”, “ไมโครซอฟต์” |
| l | l (U+006C) | ฉัน (U+0049) | ละติน | “กูเกิล”, “ไมโครซอฟต์” |
| c | c (U+0063) | с (U+0441) | ซิริลลิก | “เฟซบุ๊ก”, “miсrosoft” |
| p | p (U+0070) | р (U+0440) | ซิริลลิก | “paypal”, “dropbox” |
| s | ส (U+0073) | ѕ (U+0455) | ซิริลลิก | “ไมโครซอฟต์”, “แล็ค” |
| y | y (U+0079) | у (U+0443) | ซิริลลิก | “ยูฮู”, “เพลย์พาล” |
| x | x (U+0078) | х (U+0445) | ซิริลลิก | “хbox”, “linυx” |
| d | d (U+0064) | ԁ (U+0501) | ซิริลลิก | “เมฆแฟลร์” |
| h | ซ (U+0068) | һ (U+04BB) | ซิริลลิก | “һbo”, “һulu” |
| n | n (U+006E) | n (U+0578) | อาร์เมเนีย | “ลิปเคดิน”, “อามาโซพี” |
| m | ม (U+006D) | rn (ลำดับ) | ภาษาละติน (เทคนิคภาพลวงตา) | “ไมโครซอฟต์” แทนที่จะเป็น “ไมโครซอฟต์” |
| 0 | 0 (เลขศูนย์) | O (U+004F), о (U+043E) | ละติน / ซิริลลิก | “ไมโครซอฟต์”, “กูเกิล” |
เหตุใดการโจมตีด้วยตัวอักษรที่เหมือนกันจึงได้ผล?
- การรับรู้ของมนุษย์: ผู้คนประเมิน URL ด้วยสายตา และไม่เก่งในการสังเกตความแตกต่างเล็กน้อยของตัวอักษร
- ความไม่สอดคล้องกันระหว่างหน้าจอแสดงผลกับพื้นที่จัดเก็บข้อมูล: ระบบอาจจัดเก็บข้อมูลในรูปแบบ ASCII (Punycode) แต่แสดงผลในรูปแบบ Unicode ซึ่งก่อให้เกิดความสับสน
- ช่องว่างในนโยบาย/รายชื่อผู้ได้รับอนุญาตการกำหนดรายการที่อนุญาตโดยอิงจากสตริงที่มองเห็นได้ (โดยไม่ทำการปรับให้เป็นมาตรฐาน) อาจทำให้พลาดรายการที่คล้ายคลึงกันซึ่งอิงตาม IDN ได้
- ความพร้อมใช้งานของใบรับรองและบริการโฮสติ้ง: ผู้โจมตีสามารถขอรับใบรับรอง TLS สำหรับโดเมนที่คล้ายคลึงกัน (เช่น Let's Encrypt) ซึ่งจะทำให้ดูน่าเชื่อถือมากขึ้น
- ช่องว่างด้านระบบอัตโนมัติ: ระบบรักษาความปลอดภัยจำนวนมากไม่ได้ทำการปรับมาตรฐาน Unicode หรือไม่ทำการตรวจจับตัวอักษรผสม ทำให้คำที่มีความหมายเหมือนกันแต่ความหมายต่างกัน (homographs) เล็ดลอดผ่านไปได้
กรณีการใช้งานโฮโมไกลฟ์ทั่วไปและช่องทางการโจมตี
- การโจมตีแบบ Spear-phishing และการเก็บรวบรวมข้อมูลส่วนตัว: อีเมลฟิชชิ่งมักมีลิงก์ไปยังโดเมนที่ดูคล้ายกัน ซึ่งเป็นโดเมนที่ใช้สำหรับรวบรวมข้อมูลประจำตัว
- การประนีประนอมทางอีเมลธุรกิจ (BEC): การหลอกลวงเกี่ยวกับใบแจ้งหนี้/การชำระเงิน โดยที่ชื่อที่แสดงของผู้ส่งหรือโดเมนในใบแจ้งหนี้ดูเหมือนถูกต้อง แต่มีตัวอักษรที่เหมือนกันแต่ไม่ใช่ตัวอักษรที่ถูกต้อง (homoglyphs)
- การโฆษณาที่เป็นอันตราย / การเผยแพร่มัลแวร์: ไฟล์ปฏิบัติการและการอัปเดตจะถูกจัดเก็บไว้บนโดเมนที่ดูคล้ายกัน เพื่อหลอกนักวิเคราะห์และระบบทดสอบ
- การปลอมแปลงชื่อผู้ใช้/ชื่อที่แสดง: ในแอปพลิเคชันอย่าง Slack/Teams/อีเมล ผู้โจมตีจะสร้างบัญชีโดยใช้ชื่อที่แสดงเป็นตัวอักษรที่คล้ายกับชื่อของเพื่อนร่วมงาน เพื่อแอบอ้างเป็นเพื่อนร่วมงาน
- ความสับสนในห่วงโซ่อุปทานและนักพัฒนา: ชื่อแพ็กเกจ ชื่อที่เก็บ หรือตัวระบุตัวแปรที่มีอักขระคล้ายกัน อาจทำให้นักพัฒนาดาวน์โหลดโค้ดที่เป็นอันตรายหรือเรียกใช้ไฟล์ไบนารีที่ไม่ถูกต้องได้
ตัวอย่างในโลกแห่งความเป็นจริงและรูปแบบการรณรงค์หาเสียง
เพื่อให้การดำเนินการเป็นไปอย่างมีประสิทธิภาพและมีความรับผิดชอบ ข้อมูลต่อไปนี้เป็นรูปแบบที่ไม่ระบุชื่อและพฤติกรรมที่ได้รับการรายงานต่อสาธารณะ (ไม่มีการกล่าวโทษแบรนด์ใด ๆ):
- การหลอกลวงแบบฟิชชิ่งที่มุ่งเป้าไปที่ภาคการเงิน: แคมเปญต่างๆ จะลงทะเบียนโดเมนที่คล้ายกับพอร์ทัลการชำระเงินที่มีอักขระละติน/ซีริลลิกผสมกัน จัดทำแบบฟอร์มป้อนข้อมูลประจำตัว และส่งข้อความติดตามเพื่อเพิ่มโอกาสความสำเร็จ
- การแอบอ้างเป็นผู้ให้บริการ SaaS: ผู้โจมตีได้จดทะเบียนชื่อโดเมน (IDN) ที่มีลักษณะเหมือนกับหน้าล็อกอินของซอฟต์แวร์แบบ SaaS ยอดนิยม เพื่อขโมยข้อมูลประจำตัว โดยมักจะใช้โดเมนดังกล่าวร่วมกับใบรับรอง TLS ที่ถูกต้อง และแบบฟอร์มล็อกอิน HTML ที่ดูน่าเชื่อถือ
- การแอบอ้างเป็นผู้บริหารใน BEC: การใช้ชื่อที่แสดงในโปรแกรมอีเมล (หรือการแก้ไขโดเมนเล็กน้อย) เป็นเครื่องมือในการขอโอนเงินด่วน โดยผู้กระทำผิดอาศัยความบังเอิญของผู้ใช้ที่ไม่ตรวจสอบโดเมนปลายทางที่แท้จริง
- การแพร่กระจายมัลแวร์ผ่านเว็บไซต์ดาวน์โหลดที่คล้ายคลึงกัน: พอร์ทัลดาวน์โหลดปลอม (เช่น สำหรับโปรแกรมติดตั้ง) ที่โฮสต์อยู่บนโดเมนที่มีรูปแบบตัวอักษรคล้ายกัน เพื่อผลักดันมัลแวร์ที่ระบบตรวจสอบความปลอดภัยไม่สามารถตรวจจับได้ เนื่องจากชื่อเสียงของโดเมนยังไม่เป็นที่รู้จัก
เจาะลึกทางเทคนิค — Unicode, IDN และ Punycode
ยูนิโค้ดและสคริปต์
Unicode คือชุดอักขระที่ครอบคลุมซึ่งรวมถึงอักษรหลายภาษา (ละติน ซิริลลิก กรีก อาร์เมเนีย ฮิบรู อาหรับ ฯลฯ) สัญลักษณ์หลายตัวในอักษรต่าง ๆ มีลักษณะคล้ายคลึงกันหรือเหมือนกันในขนาดตัวอักษรปกติ
IDN และ Punycode
ระบบชื่อโดเมน (DNS) ในอดีตนั้นรองรับเฉพาะ ASCII เท่านั้น เพื่อให้สามารถใช้ชื่อที่ไม่ใช่ ASCII ได้ IDNA (Internationalized Domain Names in Applications) จึงใช้ Punycode ซึ่งเป็นการเข้ารหัสที่เข้ากันได้กับ ASCII โดยมีคำนำหน้าเป็น xn-- ตัวอย่างเช่น пример (อักษรซีริลลิก) จะกลายเป็น xn--e1afmkfd
เบราว์เซอร์จะตัดสินใจว่าจะแสดงผลในรูปแบบ Unicode หรือ Punycode โดยอาศัยหลักการวิเคราะห์เชิงอนุมาน หากโดเมนใช้ตัวอักษรจากสคริปต์เดียวและสคริปต์นั้นตรงกับภาษาท้องถิ่นของผู้ใช้ เบราว์เซอร์มักจะแสดงผลในรูปแบบ Unicode ซึ่งอาจทำให้ผู้ที่คุ้นเคยกับตัวอักษรละตินเข้าใจผิดได้
ตัวอักษรผสมและอาจทำให้สับสนได้
ผู้โจมตีมักใช้โดเมนแบบผสมอักษร โดยผสมผสานอักษรละตินกับอักษรซีริลลิกหรือกรีกบางส่วนในตำแหน่งที่มีความสำคัญทางสายตา (เช่น แกนหลักของชื่อแบรนด์ จุดเริ่มต้น/จุดสิ้นสุดของป้ายกำกับโดเมน)
กลไกทางเทคนิคที่สำคัญต่อการตรวจจับ:
- รูปแบบการทำให้เป็นมาตรฐาน (NFC, NFD, NFKC) เปลี่ยนแปลงการแยกส่วน/การประกอบแบบแคนอนิก และส่งผลต่อการเปรียบเทียบสตริง
- ตารางตัวอักษรที่อาจทำให้สับสน (Unicode Consortium) แสดงรายการตัวอักษรที่อาจทำให้สับสนเมื่อมองด้วยตาเปล่า ผู้ปกป้องสามารถใช้ตารางเหล่านี้สำหรับการจับคู่แบบคลุมเครือได้
- การควบคุม BIDI (แบบสองทิศทาง) สามารถกลับการแสดงผลข้อความได้ (\u202E) ซึ่งผู้โจมตีใช้เพื่อปกปิดชื่อไฟล์หรือชื่อที่แสดง
ขั้นตอนการโจมตี — ทีละขั้นตอน
- การสำรวจและการสร้างแบรนด์ผู้โจมตีจะรวบรวมชื่อแบรนด์ โดเมนย่อยที่ใช้กันทั่วไป และสคริปต์ที่แปลเป็นภาษาต่างๆ ที่เป้าหมายใช้
- การเตรียมความพร้อมด้านโดเมน: ลงทะเบียนโดเมนที่มีรูปแบบตัวอักษรเหมือนกันผ่านผู้ให้บริการจดทะเบียนโดเมนที่ยอมรับ IDN; และอาจขอใบรับรอง TLS เพิ่มเติมได้
- การโฮสต์และเนื้อหา: ตั้งค่าหน้าเว็บหลอกลวง พอร์ทัลดาวน์โหลด หรือการเปลี่ยนเส้นทางไปยังเว็บไซต์อื่น กำหนดค่าเทมเพลตอีเมลให้ชี้ไปยังโดเมนนั้น
- จัดส่ง: ส่งอีเมล โฆษณา หรือข้อความโซเชียลที่เชื่อมโยงไปยังโดเมนที่มีรูปแบบตัวอักษรคล้ายกัน โดยใช้สัญญาณแสดงความน่าเชื่อถือทั่วไป (โลโก้ คำพูดที่คล้ายกัน)
- การรวบรวมและการใช้ประโยชน์: เก็บรวบรวมข้อมูลประจำตัว แพร่กระจายมัลแวร์ สร้างรายได้ผ่านการฉ้อโกง หรือขายในตลาดซื้อขายสิทธิ์การเข้าถึง
- วิริยะ: ใช้ข้อมูลประจำตัวที่รวบรวมได้เพื่อขยายการเข้าถึง หรือลงทะเบียนโดเมนที่คล้ายคลึงกันเพิ่มเติมเพื่อหมุนเวียนแคมเปญ
เหตุใดการตรวจจับจึงอาจล้มเหลว — ข้อผิดพลาดทางเทคนิคที่คาดไม่ถึง
- ไม่มีการปรับมาตรฐาน Unicode: เครื่องมือที่เปรียบเทียบสตริงโดยตรงโดยไม่ใช้การแปลงเป็นมาตรฐาน Unicode จะพลาดการจับคู่
- ความแตกต่างของแบบอักษร/การแสดงผล: แบบอักษรบางแบบแสดงความแตกต่าง (เช่น แบบอักษรมีเชิง) ในขณะที่แบบอักษรบางแบบซ่อนความแตกต่างไว้ (เช่น แบบอักษรไม่มีเชิงในขนาดเล็ก)
- หลักการวิเคราะห์แบบผสมผสานภาษา: ตัวกรองบางตัวไม่ตรวจจับสคริปต์แบบผสม บางการตรวจสอบความถูกต้องจะตรวจสอบเฉพาะ ASCII เท่านั้น
- TLS ทำให้เกิดความรู้สึกปลอดภัยที่ผิดพลาด: ใบรับรองที่ถูกต้องไม่ใช่หลักฐานยืนยันตัวตน ความโปร่งใสของใบรับรองช่วยได้ แต่ไม่ได้ป้องกันรูปแบบการลงทะเบียนที่ซ้ำซ้อน
การทำแผนที่ MITER ATT&CK (ระดับสูง)
- การโจมตีแบบโฮโมกลิฟมักเกิดขึ้นควบคู่กับการเข้าถึงครั้งแรกโดยใช้กลอุบายฟิชชิ่ง โดยที่โดเมนที่คล้ายคลึงกันจะใช้เป็นที่ตั้งหน้าเว็บสำหรับเก็บรวบรวมข้อมูลประจำตัว
- ผู้โจมตีอาศัยข้อมูลข่าวกรองแบบโอเพนซอร์สเพื่อสร้างเป้าหมายการปลอมแปลงที่ดูน่าเชื่อถือ และได้มาซึ่งโดเมนและใบรับรอง TLS ที่หลอกลวงในระหว่างขั้นตอนการพัฒนาทรัพยากร
- เทคนิคการปลอมแปลงตัวตนถูกนำมาใช้เพื่อหลีกเลี่ยงระบบป้องกัน ซึ่งท้ายที่สุดแล้วจะนำไปสู่การขโมยข้อมูลประจำตัว การฉ้อโกง หรือการบุกรุกในวงกว้าง
| ระยะ | เทคนิค | รหัส ATT&CK | ความเกี่ยวข้องของโฮโมกลิฟ |
| การเข้าถึงเบื้องต้น | ฟิชชิ่ง: ลิงก์สเปียร์ฟิชชิ่ง | T1566.002 | โดเมนที่คล้ายคลึงกันจะโฮสต์หน้าข้อมูลประจำตัว |
| การลาดตระเวน | ค้นหาเว็บไซต์/โดเมนที่เปิดอยู่ | T1593 | OSINT ถูกนำมาใช้เพื่อสร้างโฮโมกลิฟที่จำเพาะเจาะจงต่อเป้าหมาย |
| การพัฒนาทรัพยากร | ซื้อโดเมน | T1583.001 | ลงทะเบียนโดเมนโฮโมกลิฟและใบรับรอง TLS |
| การหลบเลี่ยงการป้องกัน | การปลอมแปลง / การตั้งชื่อที่หลอกลวง | T1036 | คำพ้องรูปเลียนแบบชื่อที่น่าเชื่อถือ |
| การเข้าถึงข้อมูลประจำตัว | การหลอกลวงเพื่อขโมยข้อมูลประจำตัว | T1531/T1556 | ข้อมูลประจำตัวที่ถูกเก็บรวบรวมไว้ถูกนำมาใช้ในการเข้าควบคุมระบบ |
| เรื่องราว | ข้อมูลถูกเข้ารหัสเพื่อป้องกันผลกระทบ/การฉ้อโกง | T1486/T1490 | เวกเตอร์เริ่มต้นนำไปสู่การบุกรุกที่ใหญ่ขึ้น |
มาตรการป้องกันและข้อเสนอแนะในการปฏิบัติงาน
นโยบายและการกำกับดูแล
- องค์กรควรมีกลยุทธ์การป้องกันโดเมนอย่างเป็นทางการ ซึ่งรวมถึงการจดทะเบียนโดเมนที่คล้ายคลึงกันสำหรับแบรนด์และบริการที่มีมูลค่าสูง
- นโยบายการใช้งาน IDN ที่ชัดเจนควรห้ามการใช้โดเมนที่มีทั้งภาษาเขียนแบบผสมในเอกสารราชการ
การควบคุมทางเทคนิค
- เกตเวย์อีเมลและพร็อกซีเว็บต้องปรับมาตรฐาน Unicode และแสดงคำเตือน Punycode อย่างชัดเจนสำหรับลิงก์ที่น่าสงสัย
- ระบบกรอง DNS ควรพิจารณาโดเมน xn-- ที่พบใหม่ว่าเป็นโดเมนที่มีความเสี่ยงสูง จนกว่าจะได้รับการตรวจสอบ
- การตรวจสอบความโปร่งใสของใบรับรองควรแจ้งเตือนทีมรักษาความปลอดภัยเมื่อมีการออกใบรับรองสำหรับโดเมนที่คล้ายคลึงกัน
การปฏิบัติงาน
- โปรแกรมตรวจสอบแบรนด์ควรติดตามการจดทะเบียนโดเมนและรายงานการละเมิดแบบเรียลไทม์
- การจำลองการโจมตีแบบฟิชชิ่งควรประกอบด้วยสถานการณ์ที่สมจริงโดยใช้ภาพตัวอักษรที่เหมือนกัน เพื่อเพิ่มความตระหนักรู้ของผู้ใช้
- คู่มือรับมือเหตุการณ์ควรบันทึกขั้นตอนการปิดเว็บไซต์ รวมถึงการแจ้งเรื่องไปยังผู้รับผิดชอบด้านการจดทะเบียนโดเมนและผู้ให้บริการโฮสติ้ง
รายการตรวจสอบแนวทางปฏิบัติที่ดีที่สุด
- บังคับใช้การตรวจสอบสิทธิ์แบบหลายปัจจัยกับบริการที่มีข้อมูลสำคัญทั้งหมด
- ปรับมาตรฐานและตรวจสอบ URL ขาเข้าทั้งหมด โดยแสดง Punycode เมื่อเหมาะสม
- ตรวจสอบความโปร่งใสของใบรับรองและข้อมูล DNS แบบพาสซีฟสำหรับโดเมนที่คล้ายคลึงกันที่จดทะเบียนใหม่
- บล็อกหรือตรวจสอบโดเมนที่มีการใช้งานหลายภาษาอย่างเข้มงวด
- ดำเนินการจำลองการโจมตีแบบฟิชชิ่งที่รวมถึงเทคนิคโฮโมไกลฟ์
- จดทะเบียนชื่อโดเมนเชิงป้องกันสำหรับแบรนด์สำคัญๆ
- ต้องมีการตรวจสอบยืนยันเพิ่มเติมสำหรับคำขอที่เกี่ยวข้องกับการเงินหรือคุณวุฒิ
เทรนด์ใหม่ที่น่าจับตามอง
- ปัจจุบันผู้โจมตีใช้ระบบอัตโนมัติในการสร้างโฮโมไกลฟ์และการจดทะเบียนโดเมนในวงกว้างมากขึ้นเรื่อยๆ
- การหลอกลวงโดยใช้ AI ช่วยเพิ่มความน่าเชื่อถือให้กับเหยื่อล่อ ในขณะที่โดเมนที่มีตัวอักษรคล้ายกันทำหน้าที่เป็นชั้นของการหลอกลวง
- การใช้ประโยชน์จากคำที่มีรูปเหมือนกันในทางที่ผิดกำลังขยายตัวเข้าสู่ห่วงโซ่อุปทานซอฟต์แวร์ผ่านชื่อแพ็กเกจและชื่อแหล่งเก็บข้อมูลที่หลอกลวง
- การปลอมแปลงตัวตนข้ามช่องทางเป็นการผสมผสานตัวอักษรที่คล้ายคลึงกันเข้ากับแพลตฟอร์มแชทและการโคลนเสียง เพื่อเพิ่มความน่าเชื่อถือและอัตราความสำเร็จ
สรุป
การโจมตีด้วยคำพ้องรูปแสดงให้เห็นว่าการเปลี่ยนแปลงทางภาพเพียงเล็กน้อยสามารถนำไปสู่ความล้มเหลวทางด้านความปลอดภัยครั้งใหญ่ได้อย่างไร โดยการใช้ประโยชน์จากความซับซ้อนของยูนิโค้ดและการรับรู้ของมนุษย์ ผู้โจมตีสามารถหลีกเลี่ยงทั้งผู้ใช้และระบบป้องกันที่ไม่ได้มาตรฐานได้
การลดผลกระทบอย่างมีประสิทธิภาพต้องอาศัยการควบคุมหลายชั้น ได้แก่ การทำให้เป็นมาตรฐานยูนิโค้ด การจับคู่ที่อาจทำให้เกิดความสับสน การตรวจจับการใช้ตัวอักษรผสม การตรวจสอบโดเมนเชิงรุก และกระบวนการตรวจสอบผู้ใช้ที่เข้มงวด เมื่อรวมมาตรการเหล่านี้เข้าด้วยกัน จะเพิ่มต้นทุนและความซับซ้อนสำหรับผู้โจมตีอย่างมาก ทำให้เทคนิคการหลอกลวงแบบง่ายๆ กลายเป็นภัยคุกคามที่มีประสิทธิภาพน้อยลงอย่างมาก
Authors
ผู้เขียน: มาติน ทัดวี
ผู้เขียนร่วม: นิราช มาคาซาเร