

Katika ulimwengu wa kisasa unaobadilika haraka, mazingira ya tishio la mtandao yanazidi kuwa magumu na mifumo inayozingatia saini inarudi nyuma ili kulinda miisho. Suluhisho zote kuu za usalama zimeundwa kwa mifano ya usalama iliyowekwa safu ili kulinda ncha dhidi ya vitisho vya hali ya juu vya leo. Ugunduzi unaotegemea ujifunzaji wa mashine pia unakuwa sehemu isiyoepukika ya miundo hii ya usalama yenye safu. Katika chapisho hili, tutajadili jinsi Quick Heal inavyojumuisha kujifunza kwa mashine (ML) katika bidhaa zake ili kulinda vidokezo.
Matumizi ya ML au AI (akili bandia) tayari yamekubaliwa na sekta ya usalama. Sisi, kwa Quick Heal, tunatumia ML kwa hali tofauti za utumiaji. Mojawapo ni safu ya awali ya ulinzi wetu wa ngazi mbalimbali. Lengo kuu la safu hii ni kuamua kutiliwa shaka kwa faili au sampuli fulani. Ikipata faili kuwa ya kutiliwa shaka, basi faili itachunguzwa kwa tabaka zinazofuata. Kuchuja huku kunapunguza mzigo kwenye tabaka zingine za usalama.
Hapa, tutajadili jinsi tunavyotumia uchanganuzi tuli wa faili za PE kwa kutumia ML kuchuja trafiki iliyotumwa kwa safu zinazofuata za usalama.
Muhtasari wa kujifunza kwa mashine
Katika kujifunza kwa mashine, tunajaribu kuzipa kompyuta uwezo wa kujifunza kutoka kwa data badala ya kuratibiwa kwa uwazi. Katika taarifa yetu ya tatizo, tunaweza kutumia uwezo wa ML kutengeneza modeli ambayo imefunzwa kwenye data inayojulikana ya faili safi na hasidi na ambayo inaweza kutabiri zaidi asili ya faili za sampuli zisizojulikana. Sharti kuu la kuunda miundo ya ML ni kuwa na data ya mafunzo. Na lazima iwekwe lebo kwa usahihi vinginevyo matokeo na utabiri unaweza kupotosha.
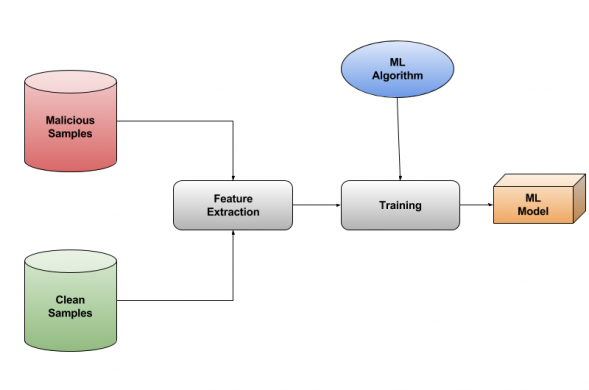
Mchakato huanza na kupanga seti iliyofunzwa kwa kukusanya idadi kubwa ya sampuli safi na hasidi na kuziweka lebo. Tunatoa vipengele kutoka kwa sampuli hizi (kwa miundo yetu tulitoa vipengele kutoka kwa vichwa vya PE vya sampuli zote zilizokusanywa). Kisha modeli hufunzwa kwa kutoa matiti haya ya kipengele kwake - kama inavyoonyeshwa kwenye mchoro wa block hapa chini.
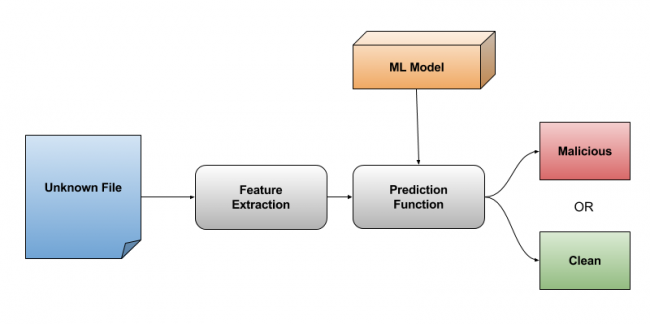
Mkusanyiko wa vipengele vya sampuli isiyojulikana hutolewa kwa mtindo huu uliofunzwa. Hurejesha alama ya kuaminika kwa sampuli hiyo inayopendekeza ikiwa faili hii ni sawa na seti safi au hasidi.
Uchaguzi wa kipengele
Kipengele ni sifa ya mtu binafsi inayoweza kupimika au sifa ya vitu vinavyozingatiwa. Kwa mfano, ikiwa tunataka kuainisha paka na mbwa tunaweza kuchukua vipengele kama vile "aina ya manyoya", "hupenda kuwa na watu wengine au hupenda kukaa peke yako", "hubweka au kutobweka", "idadi ya miguu", "kucha kali sana", nk.
Kuchagua vipengele vyema ni mojawapo ya hatua muhimu katika kufundisha mtindo wowote wa ML. Kama inavyoonyeshwa katika mfano ulio hapo juu, ikiwa tutachagua "idadi ya miguu" kama kipengele cha mafunzo, haitawezekana kuainisha kuwa mbwa na paka wana idadi sawa ya miguu. Lakini, ikiwa tutachukua "kubweka au la", itakuwa kiainishaji kizuri kama mbwa hubweka na paka hawabweki. Pia "ukali wa makucha" itakuwa sifa nzuri.
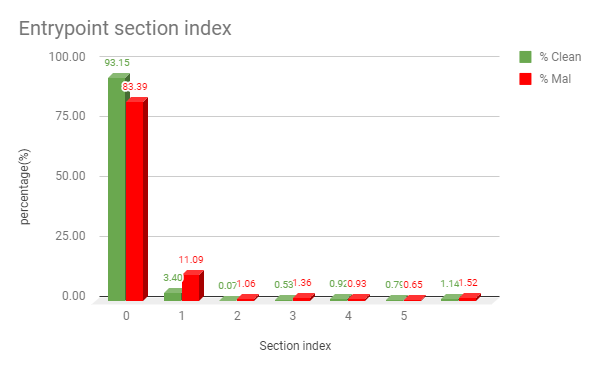
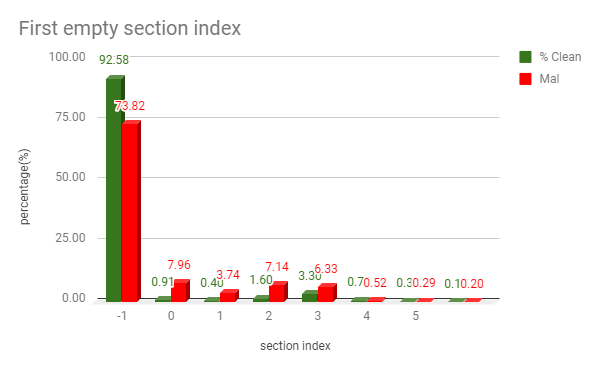
Kwa njia sawa, ili kuainisha sampuli hasidi kutoka kwa zile safi, tunahitaji kuwa na vipengele. Kwa hivyo, tunaanza na kupata sifa za kichwa cha faili ya pe ambazo zinahitaji hesabu chache ili kutoa. Tuna vipengele vya aina ya Boolean kama vile "EntryPoint iliyopo katika Sehemu ya Kwanza", "Rasilimali iliyopo" au "Sehemu ina herufi maalum katika jina lake". Na baadhi ya vipengele vinavyotegemea hesabu au thamani kama vile "NumberOfSections", "File TimeDateStamp", n.k. Baadhi ya vipengele hivi ni vikali sana kiasi kwamba mara nyingi hufanya kazi kama kitenganishi kizuri cha sampuli hasidi na zisizo na madhara. Tutajaribu kuelezea hili kwa kufuata mifano miwili. Kama inavyoonyeshwa kwenye grafu ifuatayo 1.0, katika visa vingi, kwa faili safi, sehemu ya sehemu ya kuingia ni sehemu ya 0, lakini kwa faili hasidi, inaweza kutofautiana.
Vile vile, kwa index ya "sehemu ya kwanza tupu" ya faili, tunapata njama ifuatayo.
Kuongeza kipengele
Data tunayoilisha kwa modeli yetu lazima ipanuliwe ipasavyo. Kwa mfano, thamani ya sifa kama vile Address_OF_EntryPoint = 307584 itakuwa na thamani kubwa sana ikilinganishwa na thamani ya sifa kama vile No_Of_Sections = 5. Tofauti kubwa kama hiyo inaweza kusababisha modeli yetu kutofunzwa vizuri. Tunatumia min_max scaling ili kuongeza data. Hapa, tunaleta vipengele vyote kwenye kiwango sawa katika kesi hii 0 hadi 1.
Kupunguza dimensionality
Hatua inayofuata ni kupunguza vipimo . Katika data, mara nyingi kuna makundi ya vipengele vinavyohusiana, yaani ikiwa kipengele kimoja kitabadilika, vingine pia hubadilika kwa kiwango fulani. Kuondoa au kuchanganya vipengele hivyo huokoa nafasi na muda na kuboresha utendaji wa mifumo ya kujifunza kwa mashine. Mchakato huu wa kupunguza idadi ya vipengele visivyohitajika au visivyohitajika unajulikana kama kupunguza vipimo. Hii inahakikisha mifumo inafunzwa na kupimwa haraka bila kuathiri usahihi. Tulijaribu kutumia PCA (Uchambuzi wa Vipengele Vikuu), Chagua K-Best kwa kutumia algoriti mbalimbali.
PCA hutumika kubadilisha seti ya uchunguzi wa vigeu vinavyoweza kuunganishwa kuwa seti ya thamani za vigeu visivyohusiana kwa mstari vinavyoitwa vipengele vikuu . PCA hujaribu kupata vipengele vikuu ili umbali kati ya sampuli zetu na kipengele kikuu upunguzwe. Kadiri umbali kati ya sampuli na vipengele vikuu ulivyo mdogo, ndivyo tofauti zaidi inavyohifadhiwa.
Tunaweza kutengeneza mpangilio wa tofauti ya jumla dhidi ya idadi ya vipengele vikuu ili kupata idadi ya Vipengele Vikuu (PC) vinavyohitajika ili kufunika karibu data yote. Kutumia PCA kwenye data yetu na kurekebisha inatupa PC 163 kwa karibu vipengele 1000 tofauti. Hiyo ina maana kwamba sasa tunaweza kufunza modeli kuhusu vipengele 163 ambavyo vinaweza kufunika seti kamili ya data.
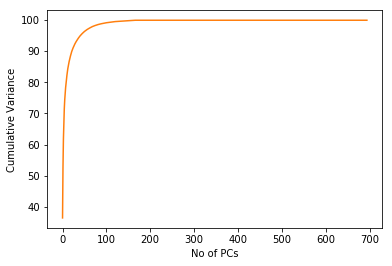
Tunaweza kubadilisha data yetu ya jaribio kuwa Vipengee hivi 163 Vikuu na tunaweza kutumia miundo ya uainishaji. Ingawa PCA inafanya kazi vizuri, tunahitaji kukokotoa Kompyuta hadi mwisho wa mteja kabla ya kutabiri. Kwa hivyo, tulitatua na Chagua K-Bora kwa kutumia takwimu za Chi-mraba, ambayo inatoa k idadi ya vipengele bora kwa kujua umuhimu wao baada ya kulinganisha data nzima.
Mafunzo
Hatua inayofuata ni kutoa mafunzo kwa modeli. Wakati wa mafunzo, tunahitaji kuzingatia vigezo vifuatavyo:
Ukubwa wa Mfano : Mfano unaozalishwa na algoriti yoyote unapaswa kuwa na ukubwa unaofaa na kusasisha kunapaswa kuchukua juhudi ndogo.
Muda wa Mafunzo : Muda na rasilimali zinazotumiwa na algoriti wakati wa mafunzo zinapaswa kuwa chache (ingawa sio hitaji la msingi).
Muda wa Utabiri : Kitendakazi cha utabiri lazima kiwe haraka iwezekanavyo.
Kuweka data kupita kiasi : Baadhi ya algoriti hufanya kazi vizuri kwenye seti ndogo za data. Lakini, tunapokua seti ya data, matokeo huwa yanapungua, hii inaitwa kuweka data kupita kiasi.
Tulijaribu algoriti chache; Urejeshaji wa Logistic ulifanya kazi vizuri kwenye seti ndogo za data lakini huwa zinaendana kupita kiasi na usahihi hupungua tunapoongeza seti ya mafunzo.
Kisha tulijaribu Kiainisha Misitu Bila Kura (Random Forest Classifier ). Usahihi hapa ni mzuri lakini ukubwa wa modeli inayozalishwa ni kubwa kwani ni msitu wa miti mingi ya uamuzi. Na kazi ya utabiri pia huchukua muda kwani miti inahitaji kupitishwa. Kwa hivyo tulihamia SVM (Mashine ya Vekta ya Usaidizi).
Msaada mashine za vector
Mashine ya vekta ya usaidizi (SVM) ni algoriti ya kujifunza ya mashine ambayo inaweza kutumika kwa changamoto za uainishaji na urekebishaji. Walakini, hutumiwa sana katika shida za uainishaji. Katika algoriti hii, tunapanga kila kipengee cha data kama sehemu katika nafasi ya n-dimensional (ambapo n ni hesabu ya vipengele ulivyo navyo) huku thamani ya kila kipengele ikiwa thamani ya kiratibu fulani. Kisha, tunafanya uainishaji kwa kutafuta hyperplane ambayo inatofautisha madarasa mawili vizuri.
Kunaweza kuwa na hyperplanes nyingi zinazoainisha data, lakini SVM inalenga kujua hyperplane ambayo ina umbali mkubwa kutoka kwa sampuli iliyo karibu iliyowekwa pande zote za ndege.
Kwa mfano, hapa SVM itachagua ndege C, kati ya A na B.
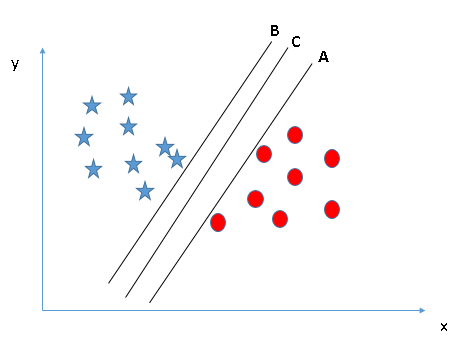
Mfano hapo juu ni wa Linear SVM. Kwa kutumia vitendakazi vya kernel katika SVM, tunaweza pia kuainisha data isiyosambazwa kwa mstari. Kitendakazi cha kernel ni kitendakazi ambacho huchukua ingizo mbili na kutoa nambari inayoonyesha jinsi zinavyofanana. Kernels zinazotumika kwa ujumla katika SVM ni Linear kernel, Polynomial kernel, Radial bias function kernel (RBF) . Tulijaribu na kernels hizi zote na tukagundua kuwa RBF na Linear hufanya kazi vizuri kwa data yetu. Kwa kuwa linear kernel ina kitendakazi cha utabiri wa haraka sana, tulikamilisha. Kitendakazi cha utabiri ni ( w*x + b ) ambapo w ni vekta ya vekta za usaidizi, x ni vekta ya kipengele cha sampuli ya jaribio na b ni intercept au bais.
Muundo wa SVM uliofunzwa kwa kutumia hatua zilizo hapo juu una usahihi mzuri sana ambao ulikaribia kupunguza 1/3 ya trafiki hadi viwango vinavyofuata. Inatusaidia sana katika kuboresha utendakazi na usahihi wa utambuzi.
Hitimisho
Kujifunza kwa mashine kunaweza kutumiwa kwa ufanisi na tasnia ya antivirus na kesi za utumiaji ni kubwa. Quick Heal imejitolea kuleta utafiti wa hivi punde zaidi katika ML ili kurekebisha usalama wa sehemu ya mwisho. Katika Quick Heal, tunafanya mazoezi ya ML katika hatua mbalimbali na uchunguzi wa kifani ulio hapo juu ni mojawapo. Katika siku zijazo, tutashiriki maandishi kwenye tafiti zingine.



