

Mbinu za Kujifunza kwa Kina na Maono ya Kompyuta zinaendelea katika kila nyanja inayowezekana. Kwa kuongezeka kwa nguvu za kompyuta, mashirika mengi huzitumia kutatua au kupunguza matatizo mengi ya kila siku. Katika mazungumzo ya hivi karibuni katika AVAR 2018 , timu ya Quick Heal AI iliwasilisha mbinu ya kutumia Deep Learning kwa ufanisi kwa uainishaji wa programu hasidi. Hapa tunatoa blogu ya kiufundi yenye maelezo ya kina kwa ajili ya hilo.
kuanzishwa
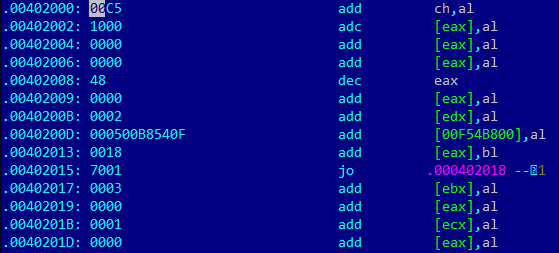
Mzizi wa mashambulizi mengi ya programu hasidi ni faili za PE ambazo kimsingi husababisha uharibifu unaotokana. Shambulio la kawaida huanza na upakuaji wa faili ya PE kupitia barua pepe, tovuti au mifumo mingine inayotumika sana. Mbinu za kitamaduni za kugundua faili hizo hasidi za PE huanzia mbinu tuli zinazotegemea sheria; mbinu tuli zinazotegemea saini hadi mbinu zinazobadilika zinazotegemea tabia kama vile viigaji, visanduku vya mchanga, n.k. Lakini zinashindwa katika mbio za kugundua programu hasidi ya hali ya juu kwa ujumla. Mchoro unaoonyeshwa hapa chini unaelezea mfano mmoja kama huo wa Crysis Ransomware ( Hii hapa ni zana ya usimbaji fiche kwa Crysis ). Hapa sampuli imefichwa sana kiasi kwamba inapita mifumo ya kugundua inayotegemea sheria au saini kwa urahisi.
Ili kukabiliana na mbinu kama hizi, tulianzisha utambuzi wa Kujifunza kwa Mashine. Ambapo, tunatumia algoriti nyingi kama vile SVM, Msitu wa Kawaida kwa utambuzi wa kawaida.
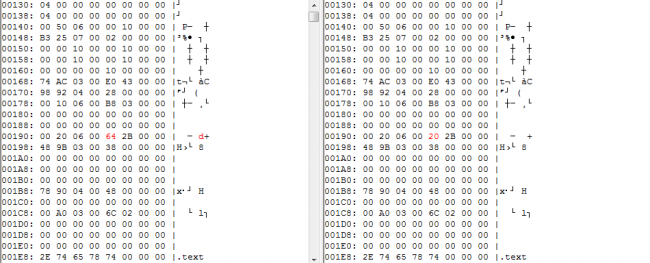
Lakini ML inahitaji ukusanyaji wa sampuli na uchimbaji wa vipengele kabla ya mafunzo. Uhandisi wa vipengele ni kazi ngumu na inahitaji utaalamu na muda wa kibinadamu. Na inazidi kuwa ngumu siku hadi siku kwani programu hasidi zinapata njia za kuikwepa. Mbinu kama vile ML ya uhasama ambapo sampuli hasidi hufunzwa kukwepa ML zinabadilika kwa kasi kubwa ili kuepuka mifumo ya ML inayotegemea sifa. Hebu tuangalie mfano mwingine. Hapa kichwa cha sampuli ya infector ya XPaj kinaonyeshwa kabla na baada ya maambukizi. XPaj haifanyi mabadiliko yoyote kwenye kichwa cha faili asili wakati wa kuongezwa. Mfumo wa ML ambao umefunzwa kwa sifa za kichwa cha faili pekee hauwezi kugundua sampuli hizi.
Deep Learning imepiga hatua kubwa hivi karibuni katika uwanja wa uainishaji wa picha na maono ya kompyuta . Kuna hadithi nyingi za mafanikio kuhusu matatizo ya uainishaji wa picha kwenye Imagenet na Resnet. Kwa hivyo tulifikiria kutumia uainishaji wa picha ili kugundua faili hasidi.
Kubadilisha faili za PE kuwa Picha
Changamoto ya kwanza ni kuwakilisha faili za PE katika mfumo wa picha. Kwa kuwa tunatoka kwenye seti kubwa ya rasilimali, tuna kiasi kizuri sana cha faili za PE katika seti yetu ya data. Pia tunaweka lebo kwenye faili hizi. Ili kutengeneza picha, tulitumia zana inayojulikana ya chanzo huria inayoitwa PortEX . Zana hii hutoa aina tatu za picha kama inavyoonyeshwa kwenye michoro iliyo hapa chini.
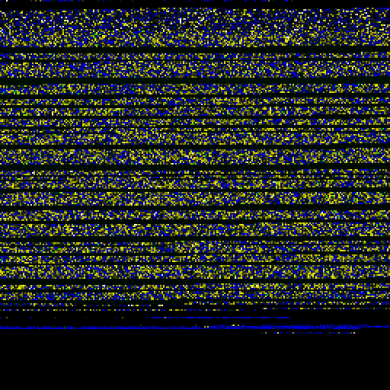
Kwanza wao (Kielelezo 3) ni picha ya njama-baiti, ambapo kila baiti au kikundi cha baiti huwakilisha pikseli ya rangi tofauti kama inavyoonyeshwa kwenye takwimu. Na kisha sufuri hupambwa mwishoni ili kuweka saizi ya picha mara kwa mara. Katika picha hii ya baiti, sufuri ni nyeusi na FF kwa saizi za rangi nyeupe. Herufi za ASCII zinazoonekana ni piksi za rangi ya samawati. Na kadhalika.
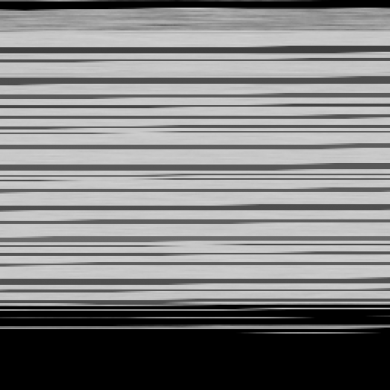
Katika aina ya pili ya picha, mizani ya saizi ya rangi moja inawakilisha baiti tofauti. Hapa (mtini 4) baiti zinawakilishwa na saizi za kijivu 0x00 kuwa nyeusi na 0xFF nyeupe.
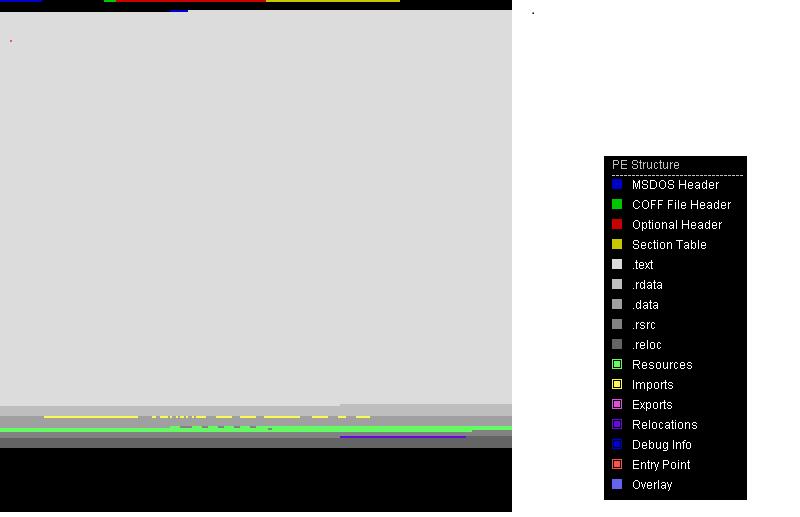
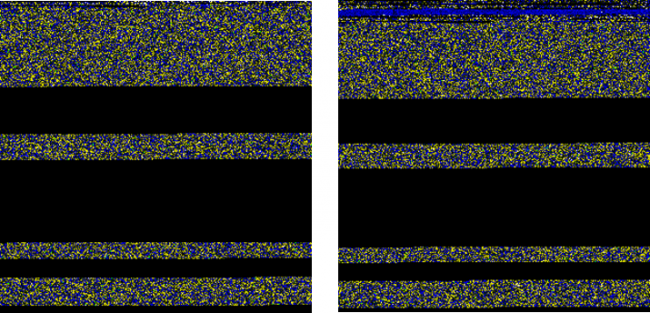
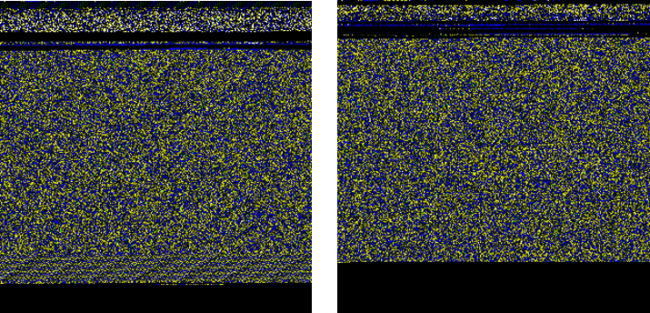
Katika aina ya mwisho (Mchoro 5), picha za muundo wa PE zinawakilisha kila muundo wa faili ya PE katika saizi za rangi tofauti. Kama ilivyo katika mfano, kijani kibichi kinawakilisha rasilimali, uagizaji wa manjano, na pikseli za samawati huwakilisha data iliyoambatishwa. Baada ya kuwakilisha faili za PE kwenye picha tunaweza kuashiria kufanana kwa faili mbili tofauti kwa kuziangalia tu. Chini ni mifano miwili ya faili kama hizo.
Kielelezo cha 6 na 7 kinaonyesha ufanano wa sampuli mbili tofauti za Wannacry na Cerber ransomware mtawalia.
Muhtasari wa Kujifunza kwa Kina
Kwa kuwa na kiasi kikubwa cha data yaani picha zilizobadilishwa kutoka kwa faili safi na zisizo, sasa tunatumia algoriti za Kujifunza kwa Kina kwenye sampuli hizi. Kujifunza kwa Kina (DL) au Mtandao wa Neva wa Kina (DNN) ni darasa maalum la Kujifunza kwa Mashine (ML). Mitandao ya Neva Bandia (ANN) ni vizuizi vya ujenzi wa DNN. ANN hupata msukumo kutoka kwa mifumo ya neva ya kibiolojia. Matatizo ya uainishaji wa picha hutumia darasa maalum la DNN. Ni Mitandao ya Neva ya Convolutional (CNN) . CNN ni darasa la mtandao rahisi wa neva ambapo matokeo hupitishwa kwenye tabaka zinazofuata bila kutengeneza mizunguko kama ilivyo kwa mitandao ya neva inayojirudia. Zina kazi zisizo za mstari ili kupunguza ulinganifu kutoka kwa vipengele vilivyofunzwa. Kuna aina nne za tabaka katika CNN na ni
- Safu ya Convolution
- Safu ya Kuunganisha
- Safu ya Kutandaza
- Safu iliyounganishwa kikamilifu
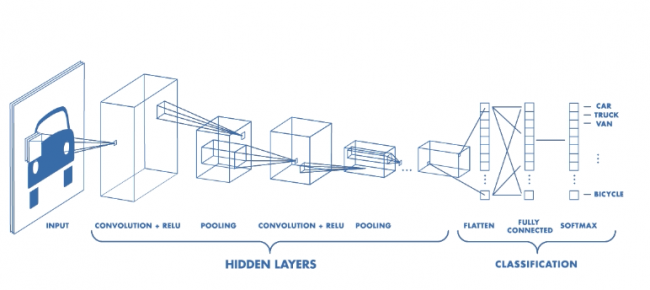
Safu ya Convolution hutumia vigunduzi vingi vya vipengele vinavyojulikana pia kama vichujio au kernels za ubadilishaji. Vichungi hivi hutelezeshwa juu ya picha ya ingizo ili kutoa ramani za vipengele. Kila kigunduzi cha vipengele hutengeneza ramani ya vipengele tofauti inayolingana na kipengele ambacho kinajaribu kujifunza. Vigunduzi vya Kipengele ni matrices ndogo kwa ujumla ya vipimo 3X3.
Kisha safu ya kuunganisha inapokea ramani hizi za vipengele vilivyotengenezwa. Safu hii inawajibika kwa kuunganisha tu vipengele ambavyo ni muhimu na kuacha vipengele visivyohitajika hivyo basi kupunguza kufaa zaidi na kuboresha muda wa mafunzo. Kuunganisha kunaweza kuwa mkusanyiko wa juu zaidi, ujumuishaji wa wastani, mkusanyiko wa wastani n.k.
Safu ya kujaa hubadilisha ramani za vipengele vilivyounganishwa kuwa vekta ya safu wima moja. Vekta hii kisha hupitishwa kwa safu iliyounganishwa kikamilifu ya ANN. Kielelezo cha 8 kinaonyesha tabaka zote za CNN rahisi.
Majaribio na Matokeo
Mara tu tunapoamua kuhusu algoriti na sampuli, mchakato wa mafunzo unafanana na mbinu zote za Kujifunza kwa Mashine kama tulivyotaja kwenye blogu yetu kuhusu kujifunza kwa mashine . Tawi lingine muhimu la DL ni Kujifunza kwa Uhamisho. Katika Kujifunza kwa Uhamisho, kazi ya mafunzo hutumia uzito wa modeli nyingine iliyofunzwa kwenye data tofauti za mafunzo kama uzito wa awali wa mchakato wa mafunzo. Mifumo kama VGG16 ina usahihi mzuri kwenye changamoto ya Imagenet. Tunaweza kuzitumia kama mahali pa kuanzia pa mafunzo yetu. Katika Jedwali la 1 tumeonyesha baadhi ya majaribio tuliyofanya kwa kutumia Kujifunza kwa Uhamisho.
| Model | Maelezo ya Mfano | Uwiano wa Ugunduzi | Uwiano wa FP | |||
| Dataset | usanifu | Idadi ya Nyakati | ||||
| Safi | zisizo | |||||
| 1 | 100k | 20k Fidia | VGG16 | 100 | 90.45 | 0.46 |
| 2 | 100k | 20k Fidia | VGG16 safu chache za mwisho Zinazoweza Kufunzwa | 100 | 91.27 | 0.21 |
| 3 | 100k | 50k | VGG16 | 20 | 89.67 | 0.38 |
| 4 | 200K | 100k | VGG16 na tabaka Zinazoweza Kufunzwa | 20 | 91.04 | 0.19 |
(Kichupo cha 1: Hamisha Majaribio ya Mafunzo)
Tulipata uwiano mzuri wa ugunduzi lakini False Positive ni mojawapo ya masuala yanayotusumbua. Tulipoongeza saizi ya seti ya mafunzo, matokeo yaliboreshwa zaidi. Katika jaribio la pili, tulitengeneza miundo ya CNN yenye safu nyingi kutoka mwanzo. Tulipata matokeo mazuri kwenye seti kubwa ya data kuliko data ya fidia. Kwa data ya fidia, tulikuwa na idadi ndogo ya sampuli za mafunzo (Jedwali la 2).
| Model | Maelezo ya Mfano | Uwiano wa Ugunduzi | Uwiano wa FP | |||
| Dataset | usanifu | Idadi ya Nyakati | ||||
| Safi | zisizo | |||||
| 1 | 100k | 20k Fidia | 8 Tabaka la CNN Model | 20 | 89.36 | 0.61 |
| 2 | 100k | 50k | 8 Tabaka la CNN Model | 20 | 91.27 | 0.84 |
| 3 | 200K | 100k | 8 Tabaka la CNN Model | 20 | 92.67 | 0.16 |
(Tab. 2: Majaribio ya Kujifunza kwa Kina)
Hitimisho
Tunapopata uwiano mzuri wa ugunduzi na muundo wa uainishaji wa picha, Mafunzo ya kina yatakuwa nyongeza nzuri kwa safu yetu ya kugundua vitisho vya hali ya juu. Lakini kama kuna ugunduzi wa uwongo pia. Kwa hivyo, hatuwezi kuitumia kama utaratibu wa kusimama pekee. Badala yake, tunachanganya uwezo wa kujifunza kwa Mashine, Kujifunza kwa Kina na uwezo unaoongezeka wa Cloud ili kupata mafanikio makubwa katika utambuzi na tutapunguza uwongo kwa kiasi kikubwa.



