

В современном быстро меняющемся мире ландшафт киберугроз становится всё более сложным, и системы на основе сигнатур всё меньше справляются с защитой конечных точек. Все основные решения безопасности построены на основе многоуровневых моделей безопасности для защиты конечных точек от современных сложных угроз. Обнаружение на основе машинного обучения также становится неотъемлемым компонентом этих многоуровневых моделей безопасности. В этой статье мы расскажем, как Quick Heal внедряет машинное обучение (МО) в свои продукты для защиты конечных точек.
Использование машинного обучения (ML) или искусственного интеллекта (ИИ) уже широко используется в индустрии безопасности. Мы, в Quick Heal, используем машинное обучение для различных целей. Один из них — начальный уровень нашей многоуровневой защиты. Основная цель этого уровня — определить подозрительность файла или образца. Если файл признан подозрительным, он будет подвергнут тщательной проверке на следующих уровнях. Такая фильтрация снижает нагрузку на другие уровни безопасности.
Здесь мы обсудим, как использовать статический анализ PE-файлов с использованием машинного обучения для фильтрации трафика, отправляемого на следующие уровни безопасности.
Обзор машинного обучения
В машинном обучении мы стремимся дать компьютерам возможность учиться на основе данных, а не запрограммировать их явно. В нашей постановке задачи мы можем использовать возможности машинного обучения для создания модели, обучаемой на известных данных из безопасных и вредоносных файлов, и способной в дальнейшем предсказывать природу неизвестных образцов файлов. Ключевым требованием для построения моделей машинного обучения является наличие данных для обучения. Они должны быть точно размечены, иначе результаты и прогнозы могут быть обманчивыми.
Процесс начинается с организации обучаемого набора путём сбора большого количества чистых и вредоносных образцов и их маркировки. Мы извлекаем признаки из этих образцов (для наших моделей мы извлекали признаки из PE-заголовков всех собранных образцов). Затем модель обучается, предоставляя ей эти матрицы признаков, как показано на блок-схеме ниже.
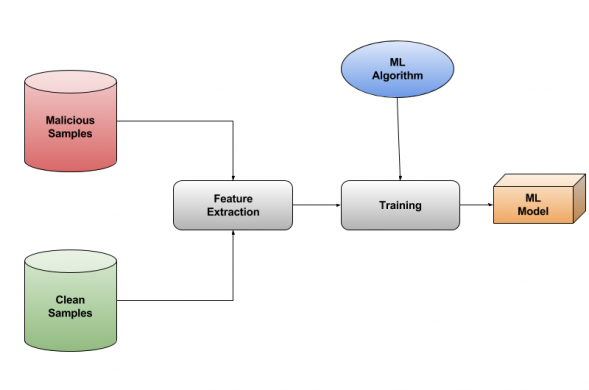
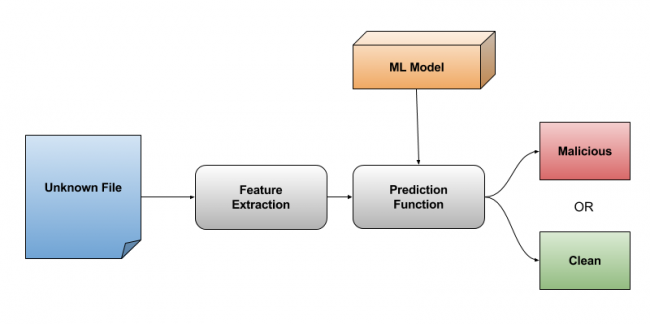
Обученной модели предоставляется массив признаков неизвестного образца. Она возвращает оценку достоверности для этого образца, показывающую, похож ли этот файл на чистый или вредоносный набор.
Выбор функции
Признак — это индивидуальное измеряемое свойство или характеристика наблюдаемых объектов. Например, если мы хотим классифицировать кошек и собак, мы можем использовать такие признаки, как «тип шерсти», «любит компанию других или предпочитает оставаться в одиночестве», «лает или нет», «количество ног», «очень острые когти» и т. д.
Выбор подходящих признаков — один из важнейших этапов обучения любой модели машинного обучения. Как показано в примере выше, если мы выберем «количество ног» в качестве признака для обучения, то не получится классифицировать, что у собак и кошек одинаковое количество ног. Но если мы возьмем «лай или нет», это будет хорошим классификатором, поскольку собаки лают, а кошки — нет. Также хорошим признаком будет «острота когтей».
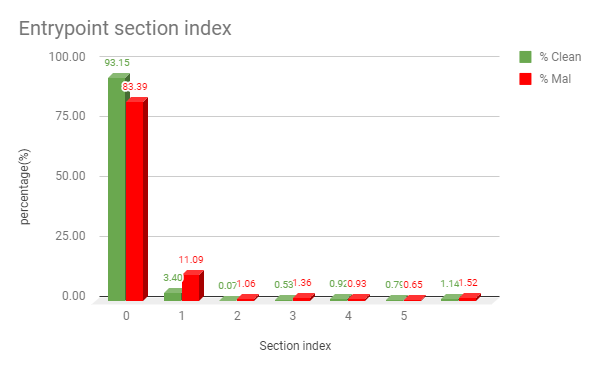
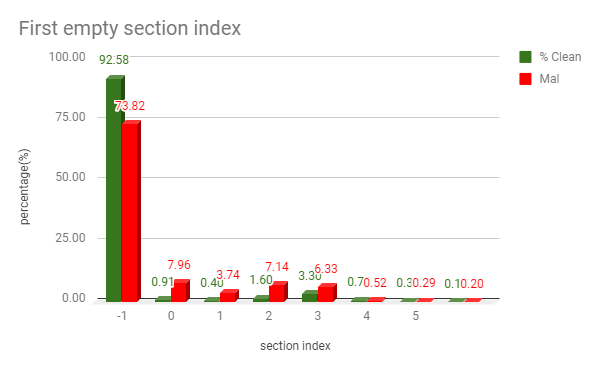
Аналогичным образом, для классификации вредоносных и чистых образцов нам необходимы признаки. Поэтому мы начинаем с извлечения атрибутов заголовка файла PE , для чего требуется меньше вычислений. У нас есть несколько логических признаков, таких как «Точка входа присутствует в первом разделе», «Ресурс присутствует» или «Раздел содержит специальный символ в своем имени». А также некоторые признаки, основанные на подсчете или значении, такие как «Количество разделов», «Меток времени и даты файла» и т. д. Некоторые из этих признаков настолько сильны, что часто служат хорошим разделителем вредоносных и безопасных образцов. Мы попытаемся объяснить это на двух примерах. Как показано на следующем графике 1.0, в большинстве случаев для чистых файлов точка входа находится в нулевом разделе, но для вредоносных файлов это может быть иначе.
Аналогично, для индекса «Первый пустой раздел» файла мы получаем следующий график.
Масштабирование функций
Данные, которые мы передаем нашей модели, должны быть правильно масштабированы. Например, значение атрибута Address_OF_EntryPoint = 307584 будет очень большим по сравнению со значением атрибута No_Of_Sections = 5. Такая огромная разница может привести к плохому обучению модели. Для масштабирования данных мы используем алгоритм min_max . В этом случае мы приводим все признаки в один и тот же диапазон, в данном случае от 0 до 1.
Уменьшение размерности
Следующий шаг — уменьшение размерности . В данных часто встречаются группы признаков, которые коррелируют друг с другом, то есть, если один признак изменяется, другие также изменяются с определенной скоростью. Удаление или объединение таких признаков экономит место и время, а также повышает производительность моделей машинного обучения. Этот процесс уменьшения количества нежелательных или избыточных признаков известен как уменьшение размерности. Это обеспечивает более быстрое обучение и тестирование моделей без ущерба для точности. Мы попробовали использовать PCA (анализ главных компонентов) и метод выбора K-лучших с помощью различных алгоритмов.
Метод главных компонент (PCA) используется для преобразования набора наблюдений потенциально коррелированных переменных в набор значений линейно некоррелированных переменных, называемых главными компонентами . PCA пытается найти главные компоненты таким образом, чтобы расстояние между нашими выборками и главной компонентой было минимизировано. Чем меньше расстояние между выборками и главными компонентами, тем больше дисперсии сохраняется.
Мы можем построить график зависимости кумулятивной дисперсии от количества главных компонент, чтобы определить количество главных компонент (ПК), необходимых для охвата почти всех данных. Применение метода главных компонент к нашим данным и его настройка дают нам 163 ПК для почти 1000 различных признаков. Это означает, что теперь мы можем обучить модель на 163 признаках, которые могут почти полностью охватить весь набор данных.
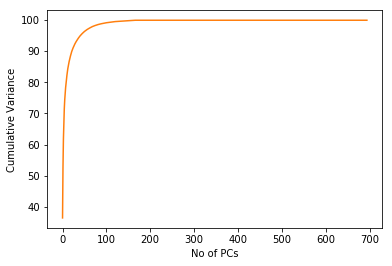
Мы можем преобразовать наши тестовые данные в эти 163 главных компонента и применить модели классификации. Хотя PCA работает отлично, нам необходимо рассчитать PC на стороне клиента перед выполнением прогнозирования. Поэтому мы остановились на методе Select K-Best с использованием критерия хи-квадрат, который позволяет получить k лучших признаков, определяя их важность после сравнения всех данных.
Обучение
Следующий шаг — обучение модели. В процессе обучения нам необходимо сосредоточиться на следующих параметрах:
Размер модели : Модель, созданная любым алгоритмом, должна иметь оптимальный размер, а ее обновление должно требовать минимальных усилий.
Время обучения : Время и ресурсы, затрачиваемые алгоритмом на обучение, должны быть минимальными (хотя это и не является основным требованием).
Время прогнозирования : Функция прогнозирования должна быть максимально быстрой.
Переобучение : Некоторые алгоритмы отлично работают на небольших наборах данных. Но по мере увеличения объема данных результаты, как правило, ухудшаются; это называется переобучением.
Мы протестировали несколько алгоритмов; логистическая регрессия хорошо работала на небольших наборах данных, но она склонна к переобучению, и точность снижается по мере увеличения обучающего набора.
Затем мы попробовали классификатор случайного леса . Точность здесь хорошая, но размер создаваемой модели велик, поскольку это лес из множества деревьев решений. Кроме того, функция прогнозирования занимает много времени, так как необходимо пройти по деревьям. Поэтому мы перешли к SVM (методу опорных векторов).
Поддерживающие векторные машины
Метод опорных векторов (SVM) — это алгоритм машинного обучения с учителем, который может использоваться как для задач классификации, так и для задач регрессии. Однако чаще всего он применяется в задачах классификации. В этом алгоритме каждый элемент данных отображается как точка в n-мерном пространстве (где n — количество имеющихся признаков), при этом значение каждого признака представляет собой значение определённой координаты. Затем мы выполняем классификацию, находя гиперплоскость, которая правильно разделяет два класса.
Может быть много гиперплоскостей, классифицирующих данные, но SVM стремится найти гиперплоскость, которая имеет наибольшее расстояние от ближайшего набора образцов по обе стороны плоскости.
Например, здесь SVM выберет плоскость C среди A и B.
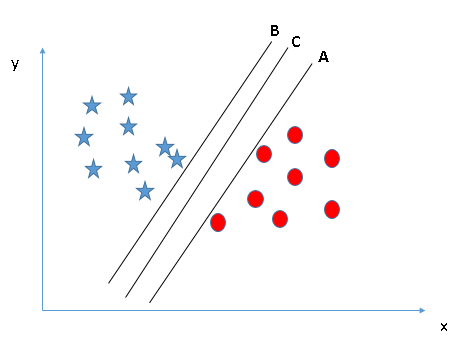
Приведенный выше пример демонстрирует линейный SVM. Используя ядерные функции в SVM, мы можем классифицировать и нелинейно распределенные данные. Ядерная функция — это функция, которая принимает два входных параметра и выдает число, представляющее степень их сходства. Обычно в SVM используются линейные ядра, полиномиальные ядра и ядра с радиальной функцией смещения (RBF) . Мы протестировали все эти ядра и обнаружили, что RBF и линейное ядро хорошо подходят для наших данных. Поскольку линейное ядро имеет чрезвычайно быструю функцию прогнозирования, мы остановились на нем. Функция прогнозирования имеет вид ( w*x + b ), где w — вектор опорных векторов, x — вектор признаков тестовой выборки, а b — свободный член или смещение.
Модель SVM, обученная с использованием описанных выше шагов, демонстрирует очень высокую точность, позволяя сократить трафик почти на треть до следующих уровней. Это значительно помогает нам повысить производительность и точность обнаружения.
Заключение
Машинное обучение может эффективно использоваться в антивирусной индустрии, и существует множество вариантов его применения. Quick Heal стремится использовать новейшие исследования в области машинного обучения для реформирования безопасности конечных точек. В Quick Heal мы применяем машинное обучение на разных этапах, и представленный выше пример — один из них. В будущем мы поделимся описаниями других примеров.



