

Diep leer- en rekenaarvisietegnieke maak vordering in elke moontlike veld. Met groeiende rekenaarkrag gebruik baie organisasies dit om baie daaglikse probleme op te los of te verminder. In 'n onlangse praatjie by AVAR 2018 het die Quick Heal KI-span 'n benadering aangebied om diep leer effektief te gebruik vir die klassifikasie van wanware. Hier gee ons 'n gedetailleerde tegniese blog daaroor.
Inleiding
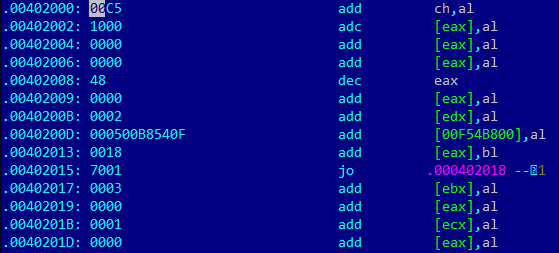
Aan die wortel van die meeste wanware-aanvalle lê PE-lêers, wat in wese die gevolglike skade veroorsaak. 'n Tipiese aanval begin met die aflaai van 'n PE-lêer via e-pos, webwerf of ander algemeen gebruikte meganismes. Tradisionele metodes om sulke kwaadwillige PE-lêers op te spoor, wissel van reëlgebaseerde; handtekeninggebaseerde statiese metodes tot gedragsgebaseerde dinamiese metodes soos emulators, sandkaste, ens. Maar hulle skiet tekort in die wedloop om gevorderde wanware generies op te spoor. Die figuur hieronder verduidelik een so 'n voorbeeld van Crysis Ransomware ( hier is die dekripsie-instrument vir Crysis ). Hierdie voorbeeld is so verdoesel dat dit reëlgebaseerde of handtekeninggebaseerde opsporingsmeganismes maklik omseil.
Om sulke meganismes te bestry, het ons masjienleer-gebaseerde opsporing bekendgestel. Waar ons baie algoritmes soos SVM, Random Forest vir generiese opsporing gebruik.
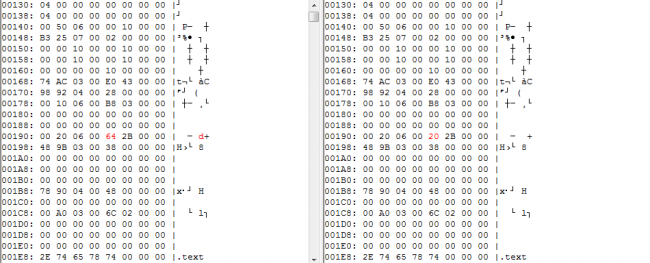
Maar ML benodig monsterversameling en kenmerk-ekstraksie voor opleiding. Kenmerk-ingenieurswese is 'n vervelige taak en vereis menslike kundigheid en tyd. En dit word daagliks meer ingewikkeld namate wanware maniere vind om dit te omseil. Tegnieke soos teenstrydige ML , waar wanware-monsters opgelei word om ML te omseil, ontwikkel teen so 'n vinnige tempo om eienskapsgebaseerde ML-modelle te ontduik. Kom ons kyk na nog 'n voorbeeld. Hier word die koptekst van die XPaj-infekteerdermonster voor en na infeksie getoon. XPaj maak amper geen verandering in die koptekst van die oorspronklike lêer tydens byvoeging nie. ML-modelle wat slegs op lêerkop-kenmerke opgelei is, kan nie hierdie monsters opspoor nie.
Diep leer het onlangs 'n lang pad gekom op die gebied van beeldklassifikasie en rekenaarvisie . Daar is baie suksesverhale oor beeldklassifikasieprobleme op Imagenet en Resnet. Daarom het ons daaraan gedink om beeldklassifikasie toe te pas om kwaadwillige lêers op te spoor.
Omskakeling van PE-lêers na beelde
Die eerste uitdaging is om PE-lêers in die vorm van beelde voor te stel. Uit 'n groot stel bronne het ons 'n baie goeie hoeveelheid PE-lêers in ons datastel. Ons benoem ook hierdie lêers. Om beelde te genereer, het ons 'n bekende oopbron-instrument genaamd PortEX gebruik . Hierdie instrument genereer hoofsaaklik drie tipes beelde soos in die diagramme hieronder getoon.
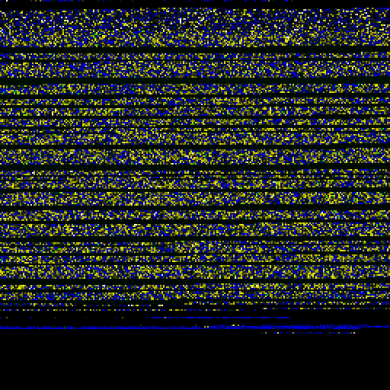
Eerstens (Fig. 3) is 'n greep-plotbeeld, waar elke greep of 'n groep grepe verskillende kleurpixels verteenwoordig soos in die figuur getoon. En dan word nulle aan die einde opgevul om die beeldgrootte konstant te hou. In hierdie greep-plotbeeld is nulle swart en FF deur wit kleurpixels. Sigbare ASCII-karakters is blou kleurpixels. Ensovoorts.
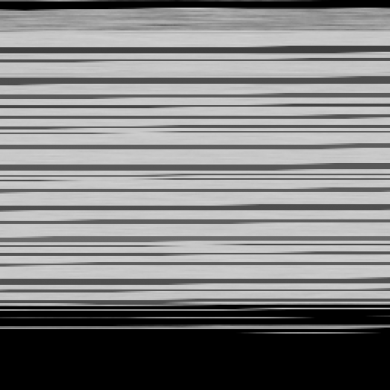
In die tweede tipe beelde verteenwoordig 'n skaal van die enkelkleurpixel verskillende grepe. Hier (fig. 4) word grepe verteenwoordig deur grysskaalpixels 0x00 wat swart is en 0xFF wit.
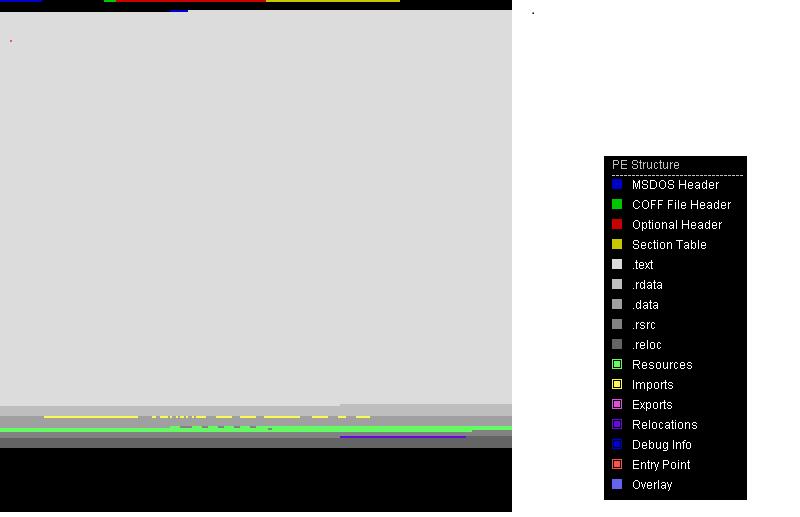
In die laaste tipe (Fig. 5) verteenwoordig PE-struktuurbeelde elke struktuur van 'n PE-lêer in verskillende gekleurde pixels. Soos in die voorbeeld, verteenwoordig groen hulpbronne, geel invoer, en lugblou pixels verteenwoordig bygevoegde data. Nadat PE-lêers in beelde voorgestel is, kan ons die ooreenkomste van twee verskillende lêers uitwys deur bloot na hulle te kyk. Hieronder is twee voorbeelde van sulke lêers.
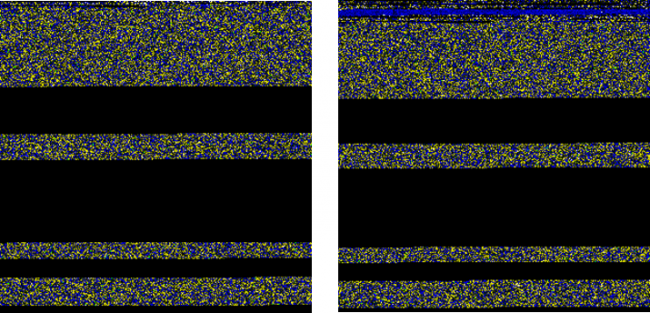
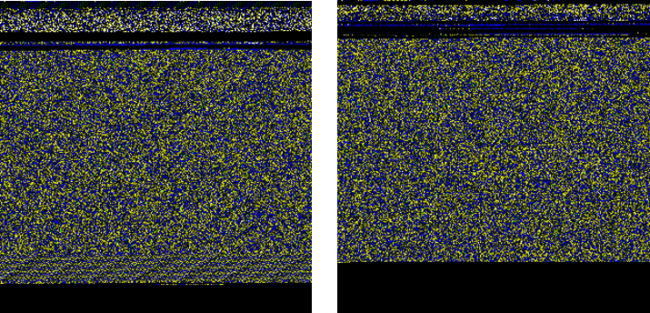
Figuur 6 en 7 toon ooreenkomste van twee verskillende voorbeelde van onderskeidelik Wannacry en Cerber ransomware.
Oorsig van diep leer
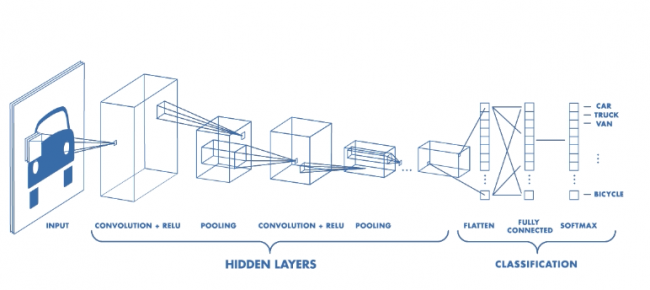
Met 'n groot hoeveelheid data, d.w.s. beelde wat van beide skoon en wanware-lêers omgeskakel is, pas ons nou diep leer-algoritmes op hierdie monsters toe. Diep leer (DL) of diep neurale netwerk (DNN) is 'n spesiale klas van masjienleer (ML). Kunsmatige neurale netwerke (ANN) is boustene van DNN's. ANN's kry inspirasie uit biologiese senuweestelsels. Beeldklassifikasieprobleme gebruik 'n spesiale klas DNN's. Hulle is konvolusionele neurale netwerke (CNN) . CNN's is 'n klas eenvoudige voorwaartse neurale netwerke waar uitsette oor die volgende lae deurgegee word sonder om siklusse te vorm soos in die geval van herhalende neurale netwerke. Hulle het nie-lineêre aktiveringsfunksies om lineariteit van opgeleide kenmerke te verminder. Daar is vier tipes lae in CNN en hulle is
- Konvolusielaag
- Poellaag
- Afplatte laag
- Volledig gekoppelde laag
Die Konvolusielaag gebruik verskeie kenmerkdetektors, ook bekend as filters of konvolusiepitte. Hierdie filters word oor 'n invoerbeeld geskuif om kenmerkkaarte te genereer. Elke kenmerkdetektor genereer 'n ander kenmerkkaart wat ooreenstem met die kenmerk wat dit probeer leer. Kenmerkdetektors is klein matrikse, gewoonlik van 3X3 afmetings.
Dan ontvang die samevoegingslaag hierdie gegenereerde kenmerkkaarte. Hierdie laag is verantwoordelik vir die samevoeging van slegs die kenmerke wat belangrik is en die agterlaat van ongewenste kenmerke, wat oorpassing verminder en opleidingstyd verbeter. Samevoeging kan maksimum samevoeging, gemiddelde samevoeging, gemiddelde samevoeging, ens. wees.
'n Platmaaklaag transformeer basies saamgevoegde kenmerkkaarte in 'n enkele kolomvektor. Hierdie vektor word dan deurgegee aan 'n volledig gekoppelde laag van 'n ANN. Figuur 8 toon alle lae van 'n eenvoudige KNN.
Eksperimente en resultate
Sodra ons op die algoritme en voorbeelde besluit het, is die opleidingsproses soortgelyk aan al die masjienleermetodes soos ons in ons blog oor masjienleer genoem het . Nog 'n nuttige tak van DL is Transfer Learning. In Transfer Learning gebruik 'n opleidingstaak gewigte van 'n ander model wat op verskillende opleidingsdata opgelei is as aanvanklike gewigte vir die opleidingsproses. Modelle soos VGG16 het goeie akkuraatheid op Imagenet-uitdagings. Ons kan dit as die beginpunt van ons opleiding gebruik. In Tabel 1 het ons 'n paar van die eksperimente getoon wat ons met behulp van Transfer Learning uitgevoer het.
| model | Model Detail | Deteksieverhouding | FP-verhouding | |||
| dataset | argitektuur | Aantal Epogge | ||||
| skoon | malware | |||||
| 1 | 100k | 20k Losprys | VGG16 | 100 | 90.45 | 0.46 |
| 2 | 100k | 20k Losprys | VGG16 laaste paar lae Opleibaar | 100 | 91.27 | 0.21 |
| 3 | 100k | 50k | VGG16 | 20 | 89.67 | 0.38 |
| 4 | 200K | 100k | VGG16 met lae Opleibaar | 20 | 91.04 | 0.19 |
(Oortjie 1: Oordragleer-eksperimente)
Ons het 'n goeie opsporingsverhouding gekry, maar Vals Positief is een van die bekommernisse. Soos ons die grootte van die oefenstel vergroot het, het die resultate verder verbeter. In die tweede eksperiment het ons meerlaagse CNN-modelle van nuuts af ontwerp. Ons het goeie resultate op 'n groter datastel as losprysdata gekry. Vir losprysdata het ons 'n beperkte aantal monsters vir opleiding gehad (Tabel 2).
| model | Model Detail | Deteksieverhouding | FP-verhouding | |||
| dataset | argitektuur | Aantal Epogge | ||||
| skoon | malware | |||||
| 1 | 100k | 20k Losprys | 8-laag CNN-model | 20 | 89.36 | 0.61 |
| 2 | 100k | 50k | 8-laag CNN-model | 20 | 91.27 | 0.84 |
| 3 | 200K | 100k | 8-laag CNN-model | 20 | 92.67 | 0.16 |
(Tabel 2: Diep Leer Eksperimente)
Gevolgtrekking
Aangesien ons 'n goeie opsporingsverhouding met die beeldklassifikasiemodel kry, gaan diep leer 'n goeie toevoeging tot ons arsenaal wees vir die opsporing van gevorderde bedreigings. Maar aangesien daar ook vals opsporings is, kan ons dit nie as 'n alleenstaande meganisme gebruik nie. In plaas daarvan kombineer ons die kragte van masjienleer, diep leer met die steeds groeiende krag van die wolk om groot sukses in opsporing te behaal en vals opsporings aansienlik te verminder.



